Hoeveel gebruikers per videokaart? Onze cijfers, machine per machine.
Mis à jour : novembre 2026
Combien de personnes par carte graphique ?
De 3 à 15, selon la carte et le modèle.
Une RTX 5060 Ti de 16 Go sert 1 à 5 personnes en même temps. Une RTX 5090 en sert 1 à 15. Une RTX PRO 6000 en sert 8 à 15, sur un modèle bien plus gros. Avec 4 cartes, on arrive à une quarantaine.
Ces chiffres sont ceux de nos fiches et de nos comparatifs. Nous les regroupons ici, machine par machine, avec ce que chacun suppose. Ce sont des repères pour dimensionner une machine, pas une mesure de vitesse ni une garantie.
Le tableau complet, machine par machine
| Machine | Cartes | Mémoire | Modèle de référence | Personnes en même temps | Prix HT |
|---|---|---|---|---|---|
| CoreIA RTX 5060 Ti | 1 | 16 Go | 8 milliards de paramètres | 1 à 5 | 1 724 € |
| CoreIA Radeon AI PRO R9700 | 1 | 32 Go | 8 à 14 milliards, texte et RAG uniquement | 1 à 12 | 3 469 € |
| CoreIA RTX 5090 | 1 | 32 Go | 8 à 14 milliards | 1 à 15 | 8 576 € |
| CoreIA RTX PRO 6000 | 1 | 96 Go | 70 milliards | 8 à 15 | 20 494 € |
| CoreIA 2x RTX 5090 | 2 | 64 Go | 30 milliards | 20 à 30 | 17 462 € |
| CoreIA 2x RTX PRO 6000 | 2 | 192 Go | 70 milliards | 20 à 35 | 40 423 € |
| CoreIA Threadripper PRO 4 GPU | 1 à 4 | 96 à 384 Go | 70 milliards | 8 à 15 avec 1 carte, une quarantaine avec 4 cartes Max-Q |
27 206 € à 1 carte |
| Serveur IA EPYC 8 GPU | 4 à 8 | 384 à 768 Go | 70 à 180 milliards | 50 à 200 |
171 791 € à 4 cartes |
Chiffres de nos comparatifs de novembre 2026, configuration de base, contexte de 8 000 tokens sur la plupart des lignes. Ils évoluent avec les choix faits au configurateur. Prix HT de la configuration de base, mis à jour automatiquement depuis notre boutique.
Les machines dont le chiffre dépend de la carte choisie
Sur ces deux serveurs, le nombre de personnes change avec les cartes prises au configurateur. Leur configuration de base a une R9700 de 32 Go.
| Machine | Mémoire selon les cartes | Personnes en même temps | Prix HT de base |
|---|---|---|---|
| Serveur IA PME EPYC 4005, 1 carte | 32 ou 96 Go | 1 à 15 | 6 511 € |
| Serveur IA Rack 4U, 1 ou 2 cartes | 32 à 192 Go | 1 à 20 | 4 694 € |
Les machines faites pour un gros modèle, pas pour une équipe
| Machine | Mémoire | Modèle de référence | Personnes en même temps | Prix HT |
|---|---|---|---|---|
| CoreIA GB10 | 128 Go de mémoire unifiée | 70 milliards | 1 à 4 | 5 833 € |
| Serveur IA EPYC 768 Go | 96 Go par carte, plus 768 Go de mémoire système au maximum | Très grand modèle, en mémoire système | 2 à 5 | Sur devis |
Leur mémoire est vaste, mais moins rapide que celle d'une carte graphique. Elles chargent ce que les autres ne peuvent pas charger. Elles servent donc peu de personnes à la fois.
Le chiffre par carte
Voici le même tableau, ramené à une carte. La dernière colonne est une simple division de nos chiffres, pas une mesure.
| Machine | Modèle de référence | Cartes | Personnes | Par carte |
|---|---|---|---|---|
| CoreIA RTX 5060 Ti | 8 milliards | 1 | 1 à 5 | 1 à 5 |
| CoreIA RTX 5090 | 8 à 14 milliards | 1 | 1 à 15 | 1 à 15 |
| CoreIA 2x RTX 5090 | 30 milliards | 2 | 20 à 30 | 10 à 15 |
| CoreIA RTX PRO 6000 | 70 milliards | 1 | 8 à 15 | 8 à 15 |
| CoreIA 2x RTX PRO 6000 | 70 milliards | 2 | 20 à 35 | 10 à 17 |
| CoreIA Threadripper PRO 4 GPU | 70 milliards | 4 Max-Q | Une quarantaine | Environ 10 |


Pourquoi la RTX PRO 6000 ne sert pas plus de monde qu'une RTX 5090
C'est l'erreur de lecture la plus fréquente. La RTX PRO 6000 a trois fois plus de mémoire que la RTX 5090, pour un nombre de personnes proche. Mais les deux lignes ne parlent pas du même modèle :
- RTX 5090 : 1 à 15 personnes sur un modèle de 8 à 14 milliards de paramètres ;
- RTX PRO 6000 : 8 à 15 personnes sur un modèle de 70 milliards.
Le modèle de la RTX PRO 6000 est 5 à 9 fois plus gros. La mémoire en plus sert donc à charger un modèle plus capable, pas à servir plus de monde. Si votre usage tient sur un petit modèle, une carte plus grosse ne vous apportera pas plus de places.
Même logique pour le GB10 : 128 Go de mémoire, mais 1 à 4 personnes sur un modèle de 70 milliards. Il charge de très gros modèles. Sa mémoire n'est pas faite pour servir une équipe.
Ce qui fait bouger le chiffre
La taille du modèle
Plus le modèle est gros, plus il occupe de mémoire et moins il en reste pour les conversations en cours. Tous nos chiffres indiquent donc le modèle de référence.
La longueur du contexte
Le contexte, c'est le texte que le modèle garde en tête pour répondre. Nos chiffres supposent 8 000 tokens, un token étant un morceau de mot. Chaque conversation en cours occupe de la mémoire pour son contexte. Si vos collègues envoient des dossiers entiers, le nombre de personnes baisse. Notre calculateur de VRAM a un réglage « sessions simultanées » pour tester votre cas.
La recherche dans vos documents
Le RAG envoie au modèle des extraits de vos documents, qui s'ajoutent au contexte. Comptez-le dans votre usage. Pour en savoir plus, lisez notre article sur la station IA avec RAG intégré.
Le nombre de cartes
Deux cartes donnent plus de mémoire, et plus de débit quand plusieurs personnes interrogent la machine en même temps. Elles ne rendent pas une réponse seule deux fois plus rapide. Le détail est dans notre guide multi-GPU.
Dimensionner en quatre étapes
1. Comptez les personnes actives au même moment
Pas votre effectif. Tout le monde n'écrit pas au même instant. Regardez l'heure la plus chargée de votre journée.
2. Choisissez le modèle
Essayez le plus petit qui fait le travail. C'est lui qui fixe la mémoire nécessaire.
3. Lisez la ligne du tableau
Prenez le bas de la fourchette si vos documents sont longs, le haut si les échanges sont courts.
4. Gardez une marge
Les usages s'ajoutent après l'installation. Une machine dimensionnée au plus juste est celle qu'on remplace le plus vite. Si vous n'êtes pas sûr, décrivez-nous votre usage : nous dimensionnons au devis.
Nos machines par nombre de personnes
Elles sont assemblées à la main à Auriol (13), hors GB10 monté par ASUS. L'assemblage prend 15 jours ouvrés maximum, souvent moins, puis vient le transport. Garantie 2 ans, extensible à 3 ou 5 ans, hors GB10.
 1 à 5 personnes : CoreIA RTX 5060 Ti16 Go, modèle de 8 milliards de paramètres.
1 724 € HT
1 à 15 personnes : CoreIA RTX 509032 Go, modèle de 8 à 14 milliards de paramètres.
8 576 € HT
 20 à 35 personnes : CoreIA 2x RTX PRO 6000192 Go, modèle de 70 milliards de paramètres.
40 423 € HT
 50 à 200 personnes : Serveur IA EPYC 8 GPU384 à 768 Go, modèle de 70 à 180 milliards de paramètres.
171 791 € HT
Dites-nous combien vous êtes
Effectif, documents, usages : nous proposons une configuration à la bonne taille, matériel et logiciel. Devis gratuit, sans engagement, réponse sous 24 h ouvrées.
Questions fréquentes
Combien d'utilisateurs une carte graphique peut-elle servir ?
Selon nos comparatifs, de 1 à 15 personnes en même temps. Une RTX 5060 Ti sert 1 à 5 personnes sur un modèle de 8 milliards de paramètres. Une RTX 5090 en sert 1 à 15 sur un modèle de 8 à 14 milliards. Une RTX PRO 6000 en sert 8 à 15 sur un modèle de 70 milliards.
Combien d'utilisateurs pour un serveur à 4 GPU ?
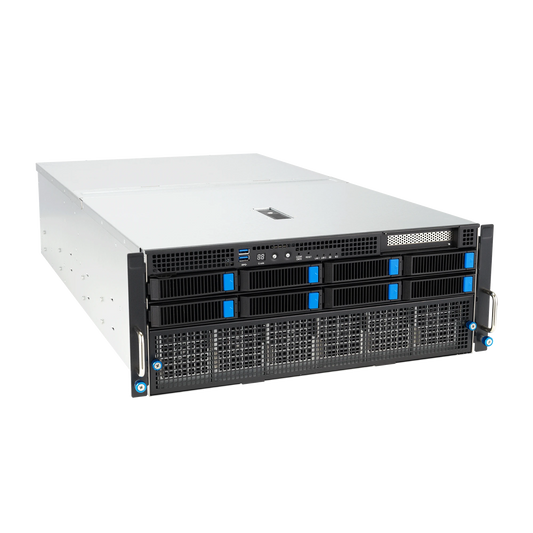
Notre station à 4 cartes RTX PRO 6000 Max-Q sert jusqu'à une quarantaine de personnes en même temps, sur un modèle de 70 milliards de paramètres. Notre serveur EPYC, de 4 à 8 cartes, sert 50 à 200 personnes, sur un modèle de 70 à 180 milliards.
Le nombre d'utilisateurs est-il le nombre de comptes ?
Non. Nos chiffres comptent les personnes actives au même moment. Il n'y a pas de limite logicielle au nombre de comptes. Une machine peut donc avoir plus de comptes que de personnes en même temps.
Doubler les cartes double-t-il le nombre d'utilisateurs ?
À peu près, d'après nos chiffres, sur des machines à 2 cartes : 8 à 15 personnes avec une RTX PRO 6000, 20 à 35 avec deux. Avec 4 cartes, on arrive à une quarantaine, soit environ 10 par carte. Le gain vient du débit et de la mémoire, pas d'une réponse individuelle plus rapide.
Pourquoi le GB10 sert-il si peu de personnes avec 128 Go ?
Sa mémoire est vaste, mais moins rapide que celle d'une carte graphique. Il charge de très gros modèles pour une petite équipe : 1 à 4 personnes sur un modèle de 70 milliards de paramètres.
Ces chiffres sont-ils garantis ?
Non. Ce sont des ordres de grandeur pour la configuration de base, avec un contexte de 8 000 tokens sur la plupart des lignes. Ils varient selon le modèle, la longueur des documents et l'usage. Pour un dimensionnement à votre cas, décrivez-nous votre projet.
Sources : fiches et comparatifs de la gamme Radiance Systems, novembre 2026. Les divisions par carte sont un calcul de lecture. Les valeurs varient selon le modèle, le moteur d'inférence et les réglages.
Laten we uw project met lokale AI bespreken
Telefonisch of via videogesprek bekijken we samen wat u nodig hebt. U krijgt een duidelijk advies, vrijblijvend.
- De AI-computer of -server die past bij uw gebruik en uw team
- Wat we voor u kunnen ontwikkelen, indien nodig: automatiseringen, applicaties en zoekopdrachten in uw documenten
- Het budget en de planning, met een offerte binnen 24 uur
Gesprekken in het Nederlands, Engels of Frans.
Uw afspraak staat!