Welke PC voor SenseNova-Loop-9B? Onze test op de RTX 5060 Ti tegenover Gemma 4 12B
Bijgewerkt: 19 november 2026
Welke PC voor SenseNova-Loop-9B?
Wij hebben het getest op een RTX 5060 Ti 16 Go, vergeleken met Gemma 4 12B.
SenseNova-Loop-9B draait probleemloos op onze kleinste IA-pc: minder dan 6 Go GPU-geheugen in 4 bits. Bij onze praktijkopdrachten is het echter drie keer trager dan Gemma 4 12B op dezelfde kaart en minder betrouwbaar. Alle cijfers van deze test zijn op 19 november 2026 op onze machine gemeten.
SenseTime heeft SenseNova-Loop-9B op 17 november 2026 gepubliceerd op Hugging Face. Dit model met 9 miljard parameters claimt de prestaties van veel grotere modellen te evenaren. Op papier is het de ideale kandidaat voor een consumentenkaart zoals de RTX 5060 Ti 16 Go. Wij hebben het geïnstalleerd, gemeten en vergeleken met Gemma 4 12B, het model dat wij dagelijks op dezelfde kaart gebruiken.
De testmachine
| Videokaart | NVIDIA GeForce RTX 5060 Ti 16 Go |
| SenseNova-Loop-9B | Officieel bestand in 4 bits (Q4_K_M, 5,8 Go), llama.cpp van SenseTime, onder Ubuntu in Windows (WSL) |
| Gemma 4 12B | 4 bits (Q4_K_M) in Ollama, op Windows |
| Gemeenschappelijke instellingen | Context van 8.192 tokens, reflectie uitgeschakeld, één verzoek tegelijk |
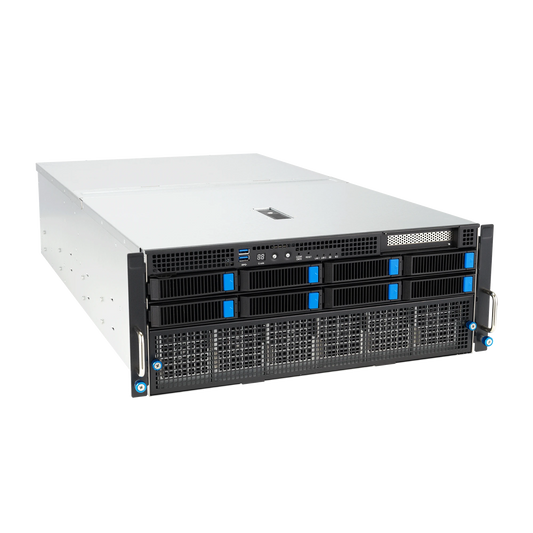
Dit is de kaart van onze CoreIA RTX 5060 Ti, onze kleinste AI-pc.
Een model dat twee keer door dezelfde lagen gaat
SenseNova-Loop-9B heeft 32 lagen, maar 24 daarvan worden bij elk token twee keer uitgevoerd met dezelfde gewichten. SenseTime spreekt van "het equivalent van 14,6 miljard parameters" tijdens de berekening. Het geheugengebruik is echter alleen afhankelijk van de 9,4 miljard parameters die daadwerkelijk worden opgeslagen.
De keerzijde: weinig geheugen, maar veel rekenkracht. In llama.cpp triggert één gegenereerd token ongeveer 52.700 operaties op de kaart. Hier wordt de snelheid bepaald. Drie van de vier lagen maken gebruik van lineaire aandacht: de contextcache is minimaal, wat een echte kwaliteit van het model is.
De gemeten snelheid
| Meting op RTX 5060 Ti 16 Go | SenseNova-Loop-9B | Gemma 4 12B |
|---|---|---|
| Generatie | 16 tokens/s | 48 tokens/s |
| Lezen van een prompt van 6.500 tokens | 450 tot 500 tokens/s | 2.080 tokens/s |
| Eerste woord, korte vraag | 2,4 tot 3 s | 0,15 s |
| Eerste prompt, prompt van 6.500 tokens | 15 s | 3,3 s |
| Antwoord van 420 tokens op deze grote prompt | 44 s | 10 s |
| Geheugen van de kaart, context van 8.192 tokens | 5,9 GB | 8,5 GB |
Metingen van Radiance Systems van 19 november 2026, dezelfde prompts voor beide modellen, reflectie uitgeschakeld. Dit zijn onze metingen op één machine en één softwareversie: een andere configuratie kan leiden tot andere cijfers.
Om een effect van WSL uit te sluiten, hebben we Gemma 4 12B ook gemeten met exact hetzelfde llama.cpp in dezelfde WSL: 39 tokens/s bij generatie, tegenover 13,5 voor SenseNova (test llama-bench). Gemma is daar bijna net zo snel als onder Windows met Ollama. De traagheid komt dus inderdaad door de loop-architectuur van SenseNova.
De kwaliteit, bij onze echte taken
De gepubliceerde scores vertellen niet het hele verhaal. We hebben beide modellen de taken laten uitvoeren die onze lokale AI elke dag doet, met exact dezelfde code:
Een assistent met tools
67 echte vragen: agenda, e-mails, cijfers, taken, offertes, interacties over meerdere beurten. Een automatische controle verifieft of de juiste tool wordt aangeroepen, of de actie daadwerkelijk wordt uitgevoerd en of er niets wordt verzonnen.
E-mails
Samenvatting in twee of drie regels, voorgesteld antwoord, opgesteld antwoord op basis van een instructie.
Vertalingen
Offerteregels en webpagina-blokken, van Frans naar Engels, Duits en Nederlands.
Voor e-mails en vertalingen is elke paar antwoorden door een aparte IA-corrector blind beoordeeld van 1 tot 5. De antwoorden werden willekeurig aangeduid met de letters A en B, zonder dat de corrector wist welk antwoord van welk model kwam.
| Taak | SenseNova-Loop-9B | Gemma 4 12B |
|---|---|---|
| Assistent met tools (automatische controle) | 52 op 67 | 67 op 67 |
| Gemiddelde tijd van een antwoord van de assistent | 14,5 s | 2,9 s |
| Volledige test van de assistent | 33 min | 4 min 20 |
| E-mail voorbereiden (samenvatting en voorgesteld antwoord) | 28 tot 61 s | 6 tot 15 s |
| Vertaling van 9 sets offertes in drie talen | 11 min | 3 min 30 |
| Vertaling van 9 webpagina-blokken | 6 min 30 | 1 min 50 |
| E-mails, gemiddelde score (15 taken) | 3,3 op 5 | 3,8 op 5 |
| Vertaling van offerteregels (9 taken) | 2,4 van 5 | 3,7 van 5 |
| Vertaling van webpagina's (9 taken) | 2,7 van 5 | 4,1 van 5 |
| Blind gewonnen taken | 6 | 22 (5 gelijkspelletjes) |
En met actieve reflectie?
SenseTime vergelijkt hun model met veel grotere modellen, waarbij de scores worden berekend door het model de tijd te geven om na te denken voordat het antwoordt. Wij hebben daarom dezelfde taken uitgevoerd met de reflectie-functie ingeschakeld voor beide modellen: 6.000 extra tokens voor reflectie en een context van 16.384 tokens. De reflectie telt nooit mee in de beoordeelde reactie en de blinde beoordeling is opnieuw uitgevoerd door een nieuwe corrector.
| Zonder, en vervolgens met reflectie | SenseNova-Loop-9B | Gemma 4 12B |
|---|---|---|
| E-mails, gemiddelde score (15 taken) | 3,3 en daarna 3,4 | 3,8 en daarna 4,1 |
| Gemiddelde tijd voor een e-mail | 37 s en daarna 84 s | 9 s en daarna 97 s |
| Offitelijnen (9 partijen) | 8 batches ingediend, gemiddelde score 2,3 | slechts 5 batches ingediend, allemaal met een score van 4 |
| Webpagina-blokken | 7 van de 9 geaccepteerd, waarvan één na 18 minuten | Geen resultaat bij de 8 gemeten items |
Reflectie overbrugt de kloof niet
SenseNova presteert matig bij e-mails, terwijl Gemma beter scoort. In het Duits en Nederlands blijft SenseNova woorden verzinnen.
Gemma 4 12B denkt eindeloos na over vertalingen
Het vult het volledige reflectiebudget, met meer dan 30.000 tekens in één blok, en levert geen enkele vertaling op. Met de door Google aanbevolen temperatuur (1,0) is het resultaat hetzelfde. Om een vertaling te krijgen, moet de reflectiefase worden beperkt.
Reflecteren kost veel tijd
Een e-mail duurt niet langer dan een paar seconden, maar nu meer dan anderhalve minuut. Bij een eenvoudige vraag denkt SenseNova korter na dan Gemma (683 tokens tegenover 2.460), maar het is drie keer minder snel: 49 seconden tegenover 54.
Waarom presteert een model dat wordt gepresenteerd op het niveau van een model met 27 miljard parameters hier minder goed? Onze aannames, die we niet hebben geverifieerd:
Lussen voegen rekenkracht toe, geen kennis
Twee keer door dezelfde lagen gaan helpt bij het redeneren, maar het vocabulaire en de talen blijven die van een model met 9 miljard parameters.
Gepubliceerde tests lijken niet op onze taken
Deze richten zich vooral op code, agenten en data-analyse, in het Engels of Chinees. Dit ligt ver af van het schrijven in het Frans, Duits en Nederlands.
Onze benchmark is geoptimaliseerd voor Gemma
Dit geeft Gemma een licht voordeel. De 4-bit compressie en de zeer recente versie van llama.cpp van SenseTime kunnen SenseNova ook een paar punten kosten.
Wat de scores van SenseTime zeggen
SenseTime vergelijkt zijn model niet met Gemma 4 12B of Qwen3.5 9B. Ze vergelijken het met Qwen3.8-27B, dat drie keer groter is, op basis van zeven door henzelf gekozen tests, voornamelijk in het Engels: gelijkwaardig of beter op vier tests, en iets minder op drie. Onze test, uitgevoerd in het Frans en op basis van onze eigen taken, geeft een veel minder gunstig beeld.
| Test (scores gepubliceerd door SenseTime) | SenseNova-Loop-9B | Qwen3.8-27B |
|---|---|---|
| GAIA (assistent met tools) | 69,9 | 67,0 |
| BIRD (SQL-queries) | 72,3 | 69,8 |
| AIDABench (data-analyse) | 65,3 | 65,0 |
| AutomationBench (automatisering) | 36,7 | 36,7 |
| Terminal-Bench 2.1 (opdrachtregelwerk) | 59,6 | 63,4 |
| NL2Repo (schrijven van een codeproject) | 41,4 | 44,6 |
| τ³-Banking (klantenservice-agent) | 30,9 | 36,1 |
Scores verstrekt door SenseTime in een grafiek op de modelpagina, gemeten met hun eigen instellingen: een indicatie van de orde van grootte, geen onafhankelijke ranglijst.
Het geheugen en de machine
| Precisie van de gewichten | GPU-geheugen | Machine |
|---|---|---|
| Q4 (4 bits), context van 8.192 tokens | 5,9 GB gemeten | CoreIA RTX 5060 Ti |
| Q4 (4 bits), contextvenster van 32.768 tokens | Geschatte 8,6 GB | CoreIA RTX 5060 Ti |
| Q8 (8 bits), contextvenster van 32.768 tokens | Geschatte 12,6 GB | CoreIA RTX 5060 Ti |
| FP16 (16 bits), context van 32.768 tokens | Geschatte 20,8 GB | CoreIA RTX 5090 |
De schattingen van Radiance Systems zijn voorzichtig: zij rekenen een aparte cache voor elke passage door de herhaalde lagen en een operationele marge. Onze meting in 4 bits ligt aanzienlijk lager.
| Machine | GPU-geheugen | Prijs excl. btw | SenseNova-Loop-9B |
|---|---|---|---|
| CoreIA RTX 5060 Ti | 16 GB | € 1.735 | Ja, in 4 of 8 bits. Dit is de kaart die we voor onze test gebruiken. |
| CoreIA RTX 5090 | 32 GB | € 9.403 | Ja, zelfs in 16 bits. Niet getest op deze kaart. |

Bekijk de CoreIA RTX 5060 Ti
De huidige installatie
Op 19 november 2026 ondersteunen noch Ollama noch LM Studio dit model. U moet de versie van llama.cpp die door SenseTime is uitgebracht compileren, aangezien er geen kant-en-klare versie voor Windows beschikbaar is. Wij hebben deze gecompileerd via Ubuntu in Windows (WSL). Let op de volgende drie valkuilen:
De juiste commit
De versie die in de modelinformatie wordt vermeld, bevindt zich niet op de hoofdbranch van de repository: u moet deze apart ophalen.
De webinterface
Het downloaden van de webinterface mislukt tijdens het compileren. U kunt deze uitschakelen: de server functioneert uitstekend zonder deze interface.
De RTX 50
U heeft CUDA 12.8 of nieuwer nodig en moet compileren voor de architectuur van de RTX 50.
Als u een machine bij ons aanschaft, installeren wij deze voor u.
De licentie
De licentie is Apache 2.0: commercieel gebruik is toegestaan, zonder omzetdrempel, mits de originele licentie en vermeldingen behouden blijven. De originele gewichten zijn te downloaden na een toegangsaanvraag op Hugging Face, die automatisch wordt goedgekeurd; de GGUF-versie is vrij toegankelijk.
Samenvatting van de licentie zoals vermeld in de modelinformatie. Dit is geen juridisch advies.
Ons oordeel
Op een RTX 5060 Ti 16 Go draait SenseNova-Loop-9B probleemloos, maar het kan niet tippenen met Gemma 4 12B. Het is drie keer trager bij het genereren, vier keer trager bij het verwerken van lange teksten en minder betrouwbaar bij praktische taken in het Frans, Duits en Nederlands.
Zijn architectuur ruilt geheugen in voor rekenkracht. Op een kaart met 16 Go is echter niet het geheugen wat tekortschiet voor een model van deze omvang: de afweging werkt dus in zijn nadeel. Het zou interessant kunnen worden zodra llama.cpp en Ollama zijn operaties hebben geoptimaliseerd. Op dit moment blijft Gemma 4 12B op deze kaart onze voorkeur.
Zoekt u iets kleiners voor eenvoudige agenten? Bekijk dan ons artikel over LFM3.
Welk model past bij uw gebruik?
Vertel ons wat u wilt automatiseren. Wij adviseren u welk model geschikt is en op welke machine dit het beste draait. Gratis offerte, zonder verplichting.
Veelgestelde vragen
Past SenseNova-Loop-9B op een RTX 5060 Ti 16 Go?
Ja. We hebben gemeten dat het ongeveer 5,9 Go GPU-geheugen verbruikt in 4-bit met een context van 8.192 tokens. Er blijft dus nog veel ruimte over op de kaart.
Wat is de snelheid op een RTX 5060 Ti 16 Go?
We hebben een snelheid van 16 tokens per seconde bij generatie gemeten, vergeleken met 48 voor Gemma 4 12B op dezelfde kaart. Dit zijn onze metingen van 19 november 2026, met een zeer recente softwareversie.
Is het beter dan Gemma 4 12B?
Niet bij onze taken. Het model slaagde voor 52 van de 67 assistenttaken, terwijl Gemma 4 12B 67 van de 67 haalde. Bovendien won Gemma 22 van de 33 blind geteste taken, tegenover 6 voor SenseNova en 5 gelijkstellingen.
Verandert de geactiveerde redenering de uitkomst?
Nee. Door het gebruik van reflectie stijgt de score van SenseNova in onze e-mails van 3,3 naar 3,4 op 5, en die van Gemma 4 12B van 3,8 naar 4,1. Echter, Gemma geeft geen vertalingen meer wanneer het reflecteert: u moet de reflectiefunctie uitschakelen om een vertaling te verkrijgen.
Waarom wordt er gesproken over 14,6 miljard parameters?
Het model voert een deel van zijn lagen twee keer uit: het berekent als een model met ongeveer 14,6 miljard parameters, maar slaat er slechts 9,4 miljard op. Het laatste getal is bepalend voor het geheugengebruik, terwijl het eerste getal de traagheid verklaart.
Werkt het met Ollama?
Nog niet op 19 november 2026. De door SenseTime gepubliceerde versie van llama.cpp moet eerst worden gecompileerd.
Kan het worden gebruikt in een bedrijf?
Ja. De licentie is Apache 2.0: commercieel gebruik is toegestaan, mits de licentie en de oorspronkelijke vermeldingen behouden blijven.
Bronnen: test van Radiance Systems op 19 november 2026 op RTX 5060 Ti 16 Go; SenseTime, fiche van SenseNova-Loop-9B ; officiële GGUF-bestanden ; llama.cpp van SenseTime ; Apache 2.0-licentie.
Laten we uw project met lokale AI bespreken
Telefonisch of via videogesprek bekijken we samen wat u nodig hebt. U krijgt een duidelijk advies, vrijblijvend.
- De AI-computer of -server die past bij uw gebruik en uw team
- Wat we voor u kunnen ontwikkelen, indien nodig: automatiseringen, applicaties en zoekopdrachten in uw documenten
- Het budget en de planning, met een offerte binnen 24 uur
Gesprekken in het Nederlands, Engels of Frans.
Uw afspraak staat!