Welke server voor Inkling 2 Small? Werkgeheugen, machine, niveau en licentie
Bijgewerkt: 13 november 2026
Welke server voor Inkling 2 Small?
Geen enkele desktop PC is voldoende: u heeft minimaal 6 kaarten nodig.
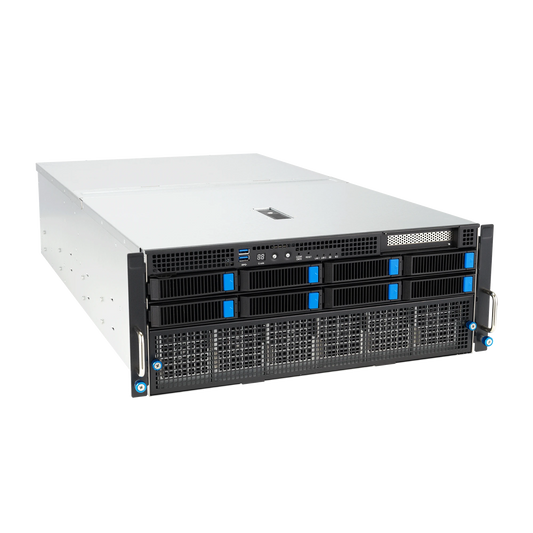
Ondanks de naam beschikt Inkling 2 Small over 594 miljard parameters. Thinking Machines vereist ten minste 500 GB GPU-werkgeheugen voor de native 4-bit versie. Bij ons betekent dit de Serveur IA EPYC 8 GPU met minstens 6 kaarten. De Apache 2.0 licentie staat commercieel gebruik toe.
Dit model verscheen op 4 november 2026 op Hugging Face en is afkomstig van Thinking Machines. Het is een Mixture of Experts model dat tekst en afbeeldingen verwerkt en in tekst antwoordt. De ontwikkelaar heeft het model ontworpen voor agents, code, assistenten en onderzoek in documenten. Hieronder vindt u de vereisten om het lokaal te draaien en de gepubliceerde scores.
Het benodigde werkgeheugen
Een expert-model wordt volledig in het geheugen geladen, ook al wordt slechts een deel gebruikt voor elk woord. Inkling 2 Small is direct getraind in 4 bits (NVFP4-formaat): dit is de native precisie en de uitgever raadt dit aan voor alle toepassingen. Er bestaat ook een 8-bits versie, maar de winst wordt door de uitgever als verwaarloosbaar beschouwd.
| Versie | GPU-geheugen | Machine uit ons assortiment |
|---|---|---|
| NVFP4 (4 bits, native) | minimaal 500 Go | Serveur IA EPYC 8 GPU met ten minste 6 RTX PRO 6000 (576 Go). De basisconfiguratie van 4 kaarten en 384 Go is onvoldoende. |
| MXFP8 (8 bits) | minimaal 800 Go | Geen machine uit ons assortiment: ons maximum is 768 Go |
| FP16 (16 bits) | ongeveer 1.114 Go | Geen machine uit ons assortiment |
De minima van 500 en 800 Go zijn de cijfers van Thinking Machines. Voor alleen de gewichten in 4 bits met 32.768 tokens context berekent ons model ongeveer 343 Go: het verschil biedt ruimte voor een lange context en de engine. Wij hanteren het cijfer van de uitgever. Het FP16-cijfer is een schatting van Radiance Systems.

Bekijk de Serveur IA EPYC 8 GPU
Welke machine?
| Machine | GPU-geheugen | Prijs HT | Inkling 2 Small |
|---|---|---|---|
| CoreIA 2x RTX PRO 6000 | 192 GB | € 40.771 | Nee, ver verwijderd van de 500 GB |
| CoreIA Threadripper PRO 4 GPU | Basis 96 GB, 384 GB met 4 kaarten |
€ 26.368 met 1 kaart, worden extra kaarten opgeteld |
Nee, maximaal 384 GB |
| Serveur IA EPYC 8 GPU | Basis 384 GB, maximaal 768 GB |
€ 188.367 met 4 kaarten, worden extra kaarten opgeteld |
Ja, met 6 tot 8 RTX PRO 6000 |
Dit is een investering in een server, geen desktop-pc. Het is een logische keuze als u een model van dit niveau lokaal wilt draaien, zonder uw gegevens naar een externe provider te sturen. De server wordt geleverd met vooraf geïnstalleerde en geteste software.
Is het goed? Het niveau volgens Thinking Machines
De specificaties vergelijken het model met andere grote open modellen, niet met Qwen3.8-27B of Gemma 4 12B: we kunnen het dus niet direct naast hen plaatsen met de beschikbare cijfers. Vergeleken met modellen in dezelfde categorie presteert het zeer goed bij kantoorgerelateerde taken (juridisch, financieel, zakelijke taken) en bij creatieve opdrachten. Bij pure code blijft DeepSeek-V4.1-Flash-1017 echter superieur. We hebben een artikel gewijd aan DeepSeek-V4.1-Flash-1017 en een ander aan MiniMax-M3.1-Flash.
| Test (scores gepubliceerd door Thinking Machines) | Inkling 2 Small | DeepSeek V4.1 Flash-1017 | MiniMax M3.1 Flash | GLM-5.3-Flash |
|---|---|---|---|---|
| JobBench (kantoortaken) | 70,5 % | 68,5 % | 67,5 % | 60,7% |
| Finance Agent (financiële agent) | 67,5% | 62,9% | 58,8% | 60,6% |
| Harvey LAB (juridisch werk) | 21,7% | 14,2% | 7,5% | 10,4% |
| Réponses sans invention (AA-Omniscience) | 73,3% | 35,9% | 6,3% | 61,7% |
| Global-MMLU-Lite (meerdere talen) | 91,0% | 90,4% | 78,5% | 89,0% |
| DeepSWE v1.1 (code) | 72,1% | 77,0% | 73,7% | 63,4% |
Scores verstrekt door Thinking Machines, gemeten met hun eigen instellingen: een orde van grootte, geen onafhankelijke ranglijst. "Réponses sans invention" verwijst naar de hallucineratio van AA-Omniscience v1.1.
De licentie voor zakelijk gebruik
Apache 2.0
Het model is gepubliceerd onder de Apache 2.0-licentie: commercieel gebruik, wijziging en herdistributie zijn toegestaan.
Opmerkingen en gebruikbeleid
Bij herdistributie moeten de licentie en de auteursrechtvermeldingen behouden blijven. Thinking Machines publiceert ook een beleid voor aanvaardbaar gebruik, dat u moet lezen voor de implementatie.
Samenvatting van de licentie op de modelkaart, die de enige geldende bron is. Dit is geen juridisch advies.
Is een model van deze omvang echt nodig?
Vaak niet. Voor een interne assistent of voor het doorzoeken van uw documenten volstaat een model met 20 tot 30 miljard parameters op één enkele kaart, tegen een aanzienlijk lagere kosten. Inkling 2 Small is gerechtvaardigd voor agenten die complexe dossiers verwerken, wanneer de kwaliteit en betrouwbaarheid van de antwoorden belangrijker zijn dan de kosten.
| Machine | GPU-geheugen | Prijs HT |
|---|---|---|
| CoreIA RTX 5060 Ti | 16 Go | 1.724 € |
| CoreIA RTX 5090 | 32 Go | 9.403 € |
Welk model past bij uw gebruik?
Vertel ons wat u wilt draaien. Wij adviseren u over de juiste machine en of een kleiner model volstaat. Gratis offerte, zonder verplichting.
Veelgestelde vragen
Hoeveel GPU-geheugen is nodig voor Inkling 2 Small?
Minimaal 500 Go voor de native versie in 4-bit (NVFP4) en minstens 800 Go voor de 8-bit versie, volgens Thinking Machines.
Waarom "Small" als het 594 miljard parameters heeft?
Het is de kleinere versie binnen de reeks van de uitgever. Het blijft een zeer groot model: in totaal 594 miljard parameters, waarvan er 17 miljard actief zijn voor elk woord.
Kan het op een enkele videokaart draaien?
Nee. Zelfs de RTX PRO 6000 met 96 Go is daar niet voldoende voor. Er is een server nodig met ten minste 6 RTX PRO 6000, zoals onze Serveur IA EPYC 8 GPU met optionele kaarten.
Is het beter dan DeepSeek-V4.1-Flash-1017?
Volgens de scores van Thinking Machines presteert het beter bij kantoorwerk, juridische zaken en financiën, en genereert het minder foutieve antwoorden. DeepSeek-V4.1-Flash-1017 blijft echter superieur in codering.
Kan het worden gebruikt in een bedrijf?
Ja. De Apache 2.0-licentie staat commercieel gebruik toe. Behoud de licentie en de vermeldingen bij herdistributie en raadpleeg de gebruiksvoorwaarden van Thinking Machines.
Welke engine gebruiken voor de hosting?
Thinking Machines publiceert recepten voor SGLang, vLLM, TokenSpeed en Unsloth.
Wat is de verwachte snelheid?
Omdat we dit model niet op onze eigen machines hebben getest, kunnen wij geen snelheid garanderen.
Bronnen: Thinking Machines, Inkling 2 Small fiche op Hugging Face ; Apache 2.0 licentie ; Thinking Machines, acceptabel gebruikbeleid. Geraadpleegd op 13 november 2026.