Whisper Local 2026: audio en video transcriberen zonder uw gegevens te verzenden
Transcrire une réunion, un entretien, un podcast ou une vidéo, automatiquement et avec une excellente précision : c'est ce que permet Whisper, le modèle de reconnaissance vocale open source. Le problème, c'est que la plupart des services de transcription en ligne envoient vos enregistrements sur des serveurs distants. Pour des données sensibles — réunions confidentielles, entretiens médicaux, consultations juridiques, contenus non publiés — c'est inacceptable.
La bonne nouvelle : Whisper tourne parfaitement en local, sur votre propre machine, sans aucune connexion internet. Vos fichiers audio et vidéo ne quittent jamais votre ordinateur. Et contrairement aux idées reçues, c'est l'un des usages d'IA les moins gourmands en matériel. Ce guide explique comment, avec quelle variante, et sur quelle machine.
Whisper en bref
Whisper est un modèle de reconnaissance vocale (speech-to-text) publié par OpenAI en open source, sous licence MIT. Il transcrit la parole en texte dans près de 99 langues, avec une précision qui rivalise avec les meilleurs services commerciaux.
L'avantage local : confidentialité totale, coût nul
Transcrire en local change tout pour les données sensibles.
- Aucun envoi vers le cloud. Vos enregistrements restent sur votre machine, de bout en bout.
- Aucun coût par minute. Les API de transcription facturent à la durée. En local, c'est gratuit, sans limite.
- Fonctionne hors ligne. Aucune connexion requise, utile en déplacement ou sur site sécurisé.
- Conforme par conception. Pour les professions soumises au secret (santé, droit, comptabilité), c'est souvent la seule option acceptable.
Quelle variante de Whisper choisir ?
Le Whisper original d'OpenAI fonctionne, mais des réimplémentations bien plus rapides se sont imposées. Voici les quatre principales en 2026.
faster-whisper
Pour la plupart des usages
La réimplémentation de référence, basée sur CTranslate2. Même précision que Whisper, mais environ 4 fois plus rapide sur GPU et 2 fois sur CPU. Le choix par défaut sur Windows et Linux avec une carte NVIDIA.
WhisperX
Sous-titres, entretiens, réunions
Construit sur faster-whisper, il ajoute l'horodatage au niveau du mot et l'identification des locuteurs (qui parle quand). Indispensable pour les sous-titres précis, les comptes-rendus de réunion et les transcriptions d'entretiens.
whisper.cpp
Mac et embarqué, sans Python
Implémentation en C, sans dépendance Python, avec accélération Metal sur Mac. Le meilleur choix sur Apple Silicon, et pour les environnements légers ou embarqués.
distil-whisper
Temps réel, faible latence
Version distillée, deux fois plus légère, pensée pour la transcription en temps réel et les sous-titres en direct, quand la latence prime sur la précision absolue.
Quelle puissance pour quel usage ?
| Usage | Modèle conseillé | VRAM | Vitesse indicative (GPU récent) |
|---|---|---|---|
| Transcription ponctuelle | large-v3-turbo | environ 6 Go | 5 à 7 fois le temps réel |
| Précision maximale, multilingue | large-v3 | environ 10 Go | 4 à 6 fois le temps réel |
| Sous-titres avec locuteurs | WhisperX (large-v3) | 10 à 16 Go | variable selon diarisation |
| Temps réel, sous-titres en direct | distil-whisper | environ 4 Go | temps réel |
| Archives en masse (batch) | insanely-fast-whisper | 12 à 16 Go | 10 fois le temps réel et plus |
Une heure d'audio se transcrit ainsi en quelques minutes sur une carte récente. Pour du traitement de gros volumes en parallèle, plus de mémoire et de puissance de calcul accélèrent linéairement le débit.
Installation rapide de faster-whisper
Sur une machine Windows ou Linux équipée d'une carte NVIDIA :
# Environnement Python dédié
python -m venv whisper-env
source whisper-env/bin/activate    # Linux/Mac
# whisper-env\Scripts\activate     # Windows

# Installation de faster-whisper
pip install faster-whisper

# Transcription d'un fichier
python -c "
from faster_whisper import WhisperModel
model = WhisperModel('large-v3-turbo', device='cuda', compute_type='int8')
segments, info = model.transcribe('reunion.mp3')
for s in segments:
    print(s.text)
"
Qui utilise Whisper en local ?
- Journalistes et chercheurs pour transcrire des entretiens sans exposer leurs sources.
- Professionnels de santé pour les comptes-rendus dictés, sans qu'aucune donnée patient ne sorte du cabinet.
- Avocats et notaires pour transcrire des consultations et des audiences confidentielles.
- Créateurs de contenu pour générer des sous-titres et des transcriptions de podcasts ou vidéos, gratuitement et sans limite.
- Entreprises pour les comptes-rendus de réunions internes, sans dépendre d'un service tiers.
- Services d'accessibilité pour le sous-titrage en temps réel.
Combiner Whisper avec une IA locale
La transcription n'est souvent que la première étape. Une fois l'audio transformé en texte, un modèle de langage local peut enchaîner : résumer la réunion, extraire les décisions et les actions, rédiger un compte-rendu structuré.
Quelle machine pour Whisper en local
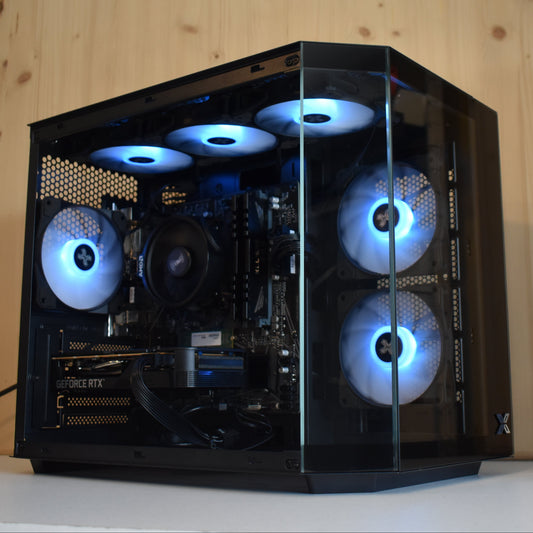
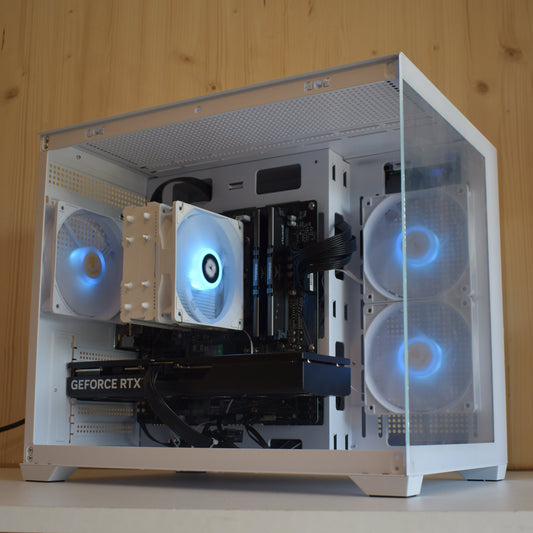
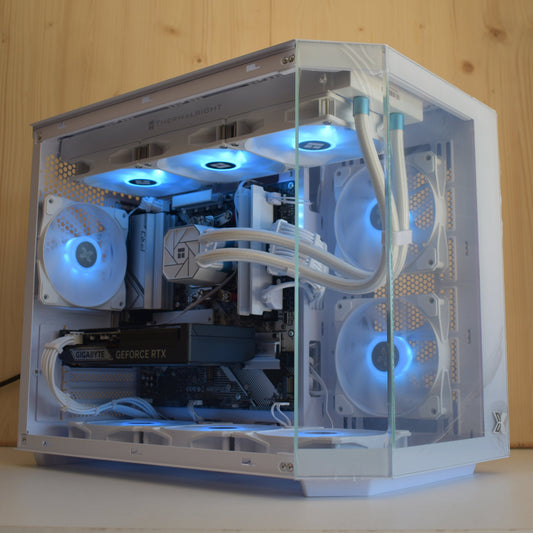
Pour de la transcription seule, une carte de 8 Go suffit largement. Si vous voulez aussi faire tourner un LLM local pour résumer et analyser, visez 16 Go ou plus. Voici nos stations adaptées, assemblées à Auriol (13390) et livrées dans toute l'UE. Si la transcription n'est qu'une première étape, notre gamme de machines IA permet d'ajouter un modèle de langage pour résumer et analyser.
 CoreIA RTX 5060 TiWhisper + LLM local pour résumer. Le bon équilibre.
2 068 €
CoreIA RTX 5090Pipeline complet WhisperX + LLM de 30 milliards de paramètres, débit maximal.
10 291 €
En bref
Whisper est-il gratuit ?
Oui, open source sous licence MIT. Vous ne payez que le matériel, une fois.
Quelle précision par rapport aux services en ligne ?
large-v3 rivalise avec les meilleurs services commerciaux, dans près de 99 langues.
Faut-il une grosse machine ?
Non. 8 Go de VRAM suffisent pour la transcription. Visez 16 Go seulement si vous ajoutez un LLM local pour résumer.
Peut-on transcrire de la vidéo ?
Oui. L'audio est extrait de la vidéo (via ffmpeg), puis transcrit. Idéal pour sous-titrer des vidéos.
Mes fichiers restent-ils privés ?
Oui, totalement. En local, aucun enregistrement ne quitte votre machine.