Lokale PC voor OpenClaw: welk hardware kiezen? | Radiance Systems
Deel
OpenClaw is een agents-AI-framework dat volledig op uw eigen computer draait. Maar om er echt alles uit te halen, snelle inferentie, zware modellen, een latencevrije pipeline, telt uw hardware net zoveel als uw softwareconfiguratie. Hieronder vindt u alle nodige informatie.
Door het team van Radiance Systems · · 8 minuten leestijd
- OpenClaw werkt 100 % offline zodra de modellen zijn gedownload, geen afhankelijkheid van de cloud.
- Voor een soepele gebruikservaring is het minimumvereiste: een NVIDIA GPU met minimaal 16 GB VRAM.
- Voor modellen van 30B+ streven naar een GPU met 24–32 GB VRAM of een multi-GPU systeem.
- Systeem-RAM: minimaal 32 GB DDR5 voor gemengde AI- en kantoorwerklasten.
- Radiance CoreIA workstations worden geleverd met vooraf geconfigureerde CUDA (ROCm op de CoreIA Radeon AI PRO R9700), Ollama en een omgeving die klaar is voor OpenClaw.
- Geen abonnement, geen kosten per token: uw AI hoort bij u.
Wat is OpenClaw en waarom het lokaal draaien?
OpenClaw is een open-source framework voor de orkestratie van IA-agenten. Het stelt u in staat om taalmodellen (LLM) direct vanuit uw eigen infrastructuur te implementeren, te koppelen en met ze te communiceren, zonder gebruik te maken van een externe API en zonder uw gegevens naar externe servers te sturen.
Onze belofte is simpel: u behoudt volledige controle over uw AI-pipeline. Uw documenten, uw queries en uw antwoorden verlaten uw netwerk nooit. Voor professionals die onderhevig zijn aan de AVG, medische geheimhoudingsplicht of juridische ethiek, is dit een fundamentele verschuiving.
Maar OpenClaw is veeleisend op het gebied van resources. Het draait om LLM-modellen die in GPU-geheugen worden geladen, en de prestaties hangen rechtstreeks af van uw hardware. Een standaard PC of laptop zal niet lang meegaan.
Welke PC-configuratie voor OpenClaw lokaal?
OpenClaw coördineert agents die LLM-modellen aanroepen voor inferentie. Het zijn deze modellen die de hardware-eisen bepalen. Hieronder vindt u de relevante drempels:
De videokaart: het belangrijkste onderdeel
De VRAM (videogeheugen) bepaalt welke modellen u kunt laden en hoe snel ze tokens genereren. Dit is het eerste beperkende factor.
NVIDIA-videokaarten worden voor de hand gelazen dankzij het CUDA-ecosysteem, dat het best wordt ondersteund door frameworks zoals llama.cpp, Ollama of vLLM die OpenClaw voeden. Bij de R9700 gaat Ollama via ROCm. De RTX 5000-serie (Blackwell-architectuur) biedt momenteel de beste prestatie/VRAM-verhouding op de markt voor werkstations.
Systeembreedte
RAM wordt gebruikt voor lange contextvensters, embeddings en parallelle pipelines. Minder dan 32 GB DDR5 kan leiden tot knelpunten bij complexe workflows.
Opslag
LLM-modellen zijn zwaar: van 4 GB voor een 7B-quantiseerd model tot 80 GB+ voor een full 70B-model. Plan minimaal 2 TB aan NVMe-opslag als u meerdere modellen gelijktijdig wilt opslaan.
Stap-voor-stap installatiegids voor OpenClaw op uw PC
Hier is het volledige proces om OpenClaw operationeel te krijgen onder Windows 11 of Ubuntu. Radiance CoreIA-workstations worden geleverd met CUDA-drivers (ROCm bij de CoreIA Radeon AI PRO R9700) en Ollama vooraf geïnstalleerd, wat dit proces beperkt tot 3–4 stappen. Als u liever een lokale AI-machine ontvangt die direct klaarstaat voor OpenClaw, kunnen wij deze voor verzending configureren.
Controleer of uw NVIDIA-stuurprogramma up-to-date is (versie ≥ 525) en of CUDA Toolkit geïnstalleerd is. Controleer dit in de terminal met nvidia-smi. Op Radiance-systemen is dit al gedaan.
OpenClaw maakt gebruik van Ollama om modellen lokaal te laden en te serveren. Installeer het via ollama.com of in de terminal: curl -fsSL https://ollama.com/install.sh | sh. Op Windows volstaat de GUI-installer.
In de terminal: ollama pull mistral voor een 7B-model, of ollama pull qwen2.5:32b voor een krachtiger model. Het downloadproces vindt slechts één keer plaats.
Kloon de officiële OpenClaw-opslag, installeer de Python-afhankelijkheden (venv wordt aanbevolen) en configureer vervolgens config.yaml om te verwijzen naar uw lokale Ollama-eindpunt (http://localhost:11434).
Start Ollama in de achtergrond (ollama serve) en start vervolgens OpenClaw. Uw eerste IA-agent draait volledig op uw machine, er verlaat geen enkele gegevens uw netwerk.
Voeg een RAG-laag toe door uw PDF's, Word-bestanden of lokale databases te indexeren. OpenClaw kan uw interne documenten op natuurlijke taal ondervragen, beroepsgeheim gegarandeerd.
Hardwarevergelijking: welke workstation voor welk OpenClaw-gebruik?
Niet alle PC's zijn even geschikt voor OpenClaw. Deze tabel vat de sleutelcriteria samen volgens gebruikprofielen.
| Gebruiksprofiel | Nodige VRAM | Systeem-RAM | Ondersteunde modellen | Aanbevolen tier |
|---|---|---|---|---|
| Licht individueel gebruik, 1 agent, occasioneel gebruik | 16 GB | 16–32 GB | 7B–13B Mistral, LLaMA 3.1 |
CoreIA RTX 5060 Ti |
| Regelmatig professioneel gebruik, RAG, meervoudige documenten, complexe agents | 16–24 GB | 32 GB | 13B–30B gequantiseerd Qwen 2.5, DeepSeek |
CoreIA Radeon AI PRO R9700 |
| Multigebruikerskantoor, gelijktijdige inferentie | 32 GB | 64 GB | 30B in 8 bits Mixtral, Qwen 32B |
CoreIA RTX 5090 |
| Meerdere agents op een groot model, fine-tuning | 64 GB (multi-GPU) / 128 GB geunificeerd | 128 GB | 60B bij 8 bits of 70B bij 4 bits (2x RTX 5090) / 200B bij 4 bits (GB10) Fine-tuning mogelijk |
CoreIA 2x RTX 5090 / GB10 |
Opmerking over kwantisering: modellen van 4-bit of 8-bit GGUF kunnen een 30B draaien op 16 GB VRAM, met een lichte kwaliteitsverlies. Voor kritieke professionele toepassingen is maximale precisie aan te raden, wat betekent dat uw GPU correct moet worden gedimensioneerd.
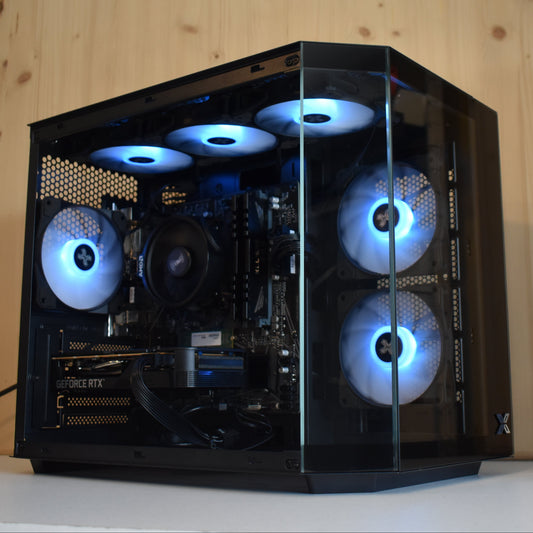
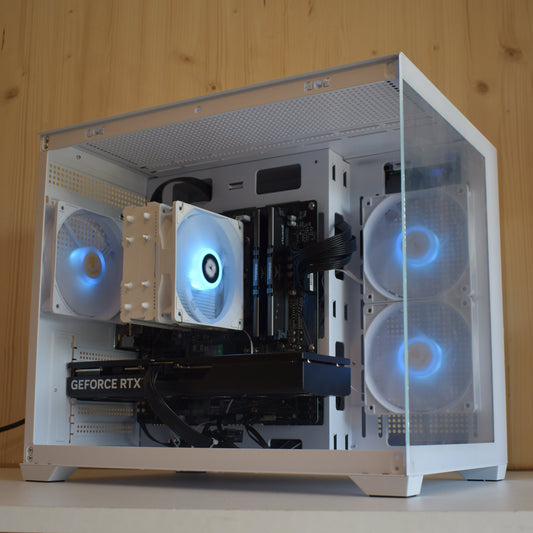
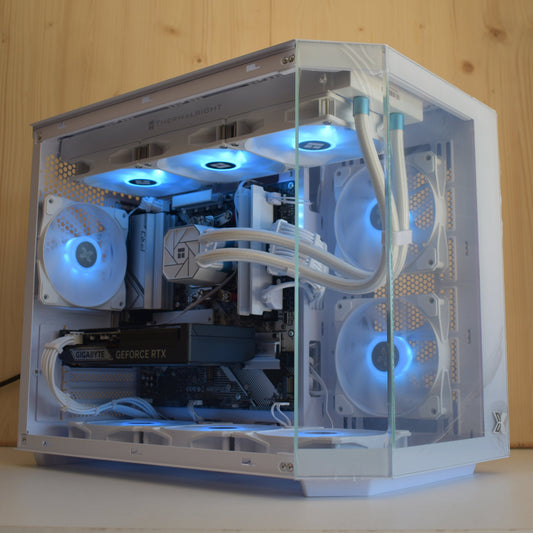
Radiance-systemen klaar voor OpenClaw
Elke machine wordt in Auriol (13) samengesteld, vooraf geconfigureerd en geleverd direct inzetbaar. CUDA-drivers (ROCm op de CoreIA Radeon AI PRO R9700), Ollama en de Python-omgeving zijn al aanwezig.
Welke LLM-modellen gebruiken met OpenClaw lokaal?
OpenClaw is compatibel met elk model dat wordt aangeboden via een API die compatibel is met OpenAI, dit omvat Ollama, llama.cpp, LM Studio of vLLM. Onze selectie 2025:
| Model | Grootte | Vereiste VRAM | Voordelen | Doelgroep |
|---|---|---|---|---|
| Mistral Small 3.1 | 24B | ~14 GB (Q4) | Snel, meertalig, nauwkeurige instructies | Algemeen gebruik, assistenten |
| Qwen 2.5 / Qwen3 | 7B–72B | 4–40 GB | Uitstekend in het Frans, sterk redeneren | Juridisch, medisch, boekhouding |
| DeepSeek-R1 | 7B–70B | 4–38 GB | Gekoppeld redeneren, code, analyse | Onderzoek & ontwikkeling, ingenieursbureaus |
| LLaMA 3.3 | 70B | ~38 GB (Q4) | Referentiemodel, veelzijdig | Elk professioneel gebruik |
| Gemma 3 | 9B–27B | 5–16 GB | Lichtgewicht, multimodaal, presteert goed op kleine GPU's | Individuele kantoren, medisch |
Voor professioneel gebruik in het Frans bieden Qwen 2.5 32B en Mistral Small 3.1 de beste balans tussen antwoordkwaliteit en inferentiesnelheid op een GPU van 16–24 GB.
Lokale AI versus cloud: de beslissende argumenten voor professionals
| Criterium | Lokale AI (OpenClaw + Radiance) | Cloud-AI (ChatGPT, Copilot…) |
|---|---|---|
| Gegevensbescherming | ✓ Volledig, niets verlaat het systeem | ✗ Gegevens worden verzonden naar de leverancier |
| RGPD-compliance | ✓ Native, geen overdracht buiten de EU | ⚠ Variabel volgens DPA-contracten |
| Kostenmodel | Enkele investering | Abschrift + facturatie per token |
| Beschikbaarheid offline | ✓ Werkt zonder internet | ✗ Vereist een permanente verbinding |
| Aanpassing / fine-tuning | ✓ Volledig op uw gegevens | Gelimiteerd per aanbod |
| Bedrijfsgeheimen | ✓ Van nature gerespecteerd | ⚠ Echte ethische risico's |
Terugblik Radiance: onze pro-tips voor OpenClaw
Wij assembleren en implementeren AI-workstations vanuit Auriol voor professionals over heel Europa. Dit zijn de lessen die we hebben geleerd uit ons veldwerk:
💡 Onderschat de NVMe-bandbreedte niet
Bij het opstarten laadt OpenClaw het model van de schijf naar de VRAM. Een NVMe Gen 4 (~7 000 Mb/s) verkort deze laadtijd met 40 tot 70 % ten opzichte van een SATA-SSD. Op onze CoreIA-machines gebruiken we NVMe Gen 4 of Gen 5.
💡 Beperk het contextvenster als u te weinig VRAM heeft
OpenClaw ondersteunt lange contexten (32K, 128K tokens). Elke token in de context verbruikt VRAM. Op een GPU met 16 GB RAM beperkt u zich tot 8K–16K tokens om een snelle generatie te garanderen. Bij 32 GB is 128K probleemloos beschikbaar.
💡 Schakel Flash Attention in als uw GPU dit ondersteunt
RTX 5000 (Blackwell) ondersteunen Flash Attention 3 van nature, wat de geheugenvoetafdruk van lange contexten met 30 tot 50 % verlaagt. Schakel deze optie in via de configuratie van uw inferentie-backend.
💡 Voor een multi-gebruikerspraktijk: serveer OpenClaw als interne API
In plaats van OpenClaw op elke werkstation te installeren, deployeert u een serverinstance op een Radiance-rackworkstation die via uw lokaal netwerk toegankelijk is. Uw medewerkers verbinden zich lokaal, de gegevens blijven lokaal en u maakt gebruik van gedeelde GPU-capaciteit.
Vraagstukken over lokale OpenClaw
Is de installatie van OpenClaw moeilijk?
Bij een standaard machine vereist de installatie kennis van het terminal en Python. Bij Radiance CoreIA workstations is de omgeving (CUDA of ROCm op de R9700, Ollama, Python) vooraf geconfigureerd, waardoor de installatie binnen ongeveer tien minuten klaar is. Onze team kan ook de initiële configuratie op afstand uitvoeren.
Kan ik lokaal fine-tuning doen met OpenClaw?
OpenClaw is een agentenorchestrator, geen fine-tuning tool. Om een model aan te passen aan uw gegevens heeft u een gespecialiseerde tool nodig (Axolotl, LLaMA-Factory) en een GPU met minimaal 24 GB VRAM voor modellen van 7B, of een multi-GPU systeem voor zwaardere modellen. Onze CoreIA 2x RTX 5090 en CoreIA RTX PRO 6000 configuraties zijn hiervoor ontworpen.
Werkt OpenClaw onder Windows?
Ja, OpenClaw ondersteunt Windows via WSL2 of in native Python. Onze CoreIA stations worden geleverd naar keuze met Windows 11 Pro met vooraf geactiveerd WSL2 of met Ubuntu, wat volledige compatibiliteit garandeert met het ecosysteem van open-source IA-tools; de CoreIA GB10 wordt geleverd met DGX OS, gebaseerd op Ubuntu.
Wat is het verschil tussen OpenClaw en Open WebUI?
Open WebUI is a graphical interface to interact with models via chat. OpenClaw is an AI agents framework, it automates complex tasks, chains model calls, integrates external tools and can reason in multiple steps. Both can coexist on the same machine.
Mijn praktijk heeft strenge AVG-verplichtingen. Is lokale IA daadwerkelijk conform?
Ja. Zodra de verwerking van persoonsgegevens plaatsvindt op uw eigen hardware, in uw eigen ruimtes, zonder overdracht naar een externe dienstverlener, bent u conform met het minimaliserings- en soevereiniteitsbeginsel van de AVG. Radiance workstations zijn specifiek ontworpen om deze architectuur standaard te garanderen.
Uw PC voor OpenClaw lokaal, samengesteld in Auriol
Vertel ons uw gebruik, uw functie en uw doelmodellen. Wij configureren de ideale machine en sturen deze naar u toe, klaar om direct te gebruiken, na maximaal 15 werkdagen aan de montage.
Vraag een gratis offerte →