Quel serveur pour Inkling 2 Small ? Mémoire, machine, niveau et licence
Mis à jour : 13 novembre 2026
Quel serveur pour Inkling 2 Small ?
Aucun ordinateur de bureau ne suffit : il faut 6 cartes au moins.
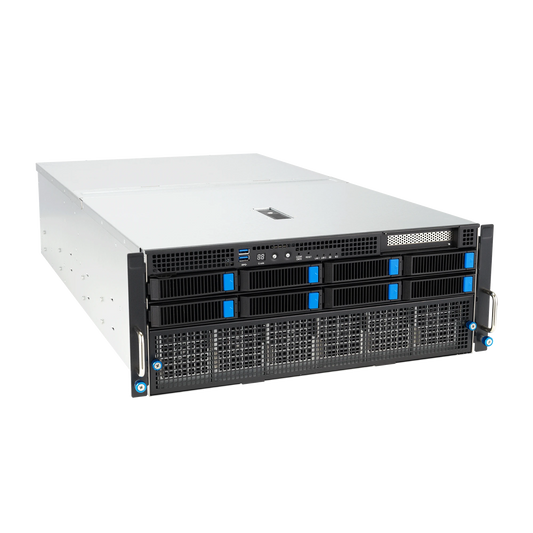
Malgré son nom, Inkling 2 Small compte 594 milliards de paramètres. Thinking Machines demande au moins 500 Go de mémoire GPU pour sa version native en 4 bits. Chez nous, cela veut dire le Serveur IA EPYC 8 GPU avec au moins 6 cartes. Sa licence Apache 2.0 autorise l'usage commercial.
Ce modèle est apparu sur Hugging Face le 4 novembre 2026. Il vient de Thinking Machines. C'est un modèle à mélange d'experts qui lit du texte et des images et répond en texte. Son éditeur le destine aux agents, au code, aux assistants et à la recherche dans des documents. Voici ce qu'il faut pour le faire tourner chez vous, et ce qu'en disent les scores publiés.
La mémoire dont il a besoin
Un modèle à experts se charge en entier en mémoire, même si seule une partie travaille à chaque mot. Inkling 2 Small a été entraîné directement en 4 bits (format NVFP4) : c'est sa précision native, et son éditeur la recommande pour tous les usages. Une version en 8 bits existe aussi, pour un gain qu'il juge négligeable.
| Version | Mémoire GPU | Machine de notre gamme |
|---|---|---|
| NVFP4 (4 bits, native) | 500 Go minimum | Serveur IA EPYC 8 GPU avec au moins 6 RTX PRO 6000 (576 Go). La configuration de base, 4 cartes et 384 Go, ne suffit pas. |
| MXFP8 (8 bits) | 800 Go minimum | Aucune machine de notre gamme : notre maximum est de 768 Go |
| FP16 (16 bits) | environ 1 114 Go | Aucune machine de notre gamme |
Les minimums de 500 et 800 Go sont ceux de Thinking Machines. Pour les poids seuls en 4 bits avec 32 768 jetons de contexte, notre calcul donne environ 343 Go : la différence laisse de la place au contexte long et au moteur. Nous retenons le chiffre de l'éditeur. Le chiffre FP16 est une estimation de Radiance Systems.

Voir le Serveur IA EPYC 8 GPU
Quelle machine
| Machine | Mémoire GPU | Prix HT | Inkling 2 Small |
|---|---|---|---|
| CoreIA 2x RTX PRO 6000 | 192 Go | 40 771 € | Non, très loin des 500 Go |
| CoreIA Threadripper PRO 4 GPU | 96 Go de base, 384 Go avec 4 cartes |
26 368 € avec 1 carte, les cartes en plus s'ajoutent |
Non, 384 Go au maximum |
| Serveur IA EPYC 8 GPU | 384 Go de base, 768 Go au maximum |
188 367 € avec 4 cartes, les cartes en plus s'ajoutent |
Oui, avec 6 à 8 RTX PRO 6000 |
C'est un investissement de serveur, pas un poste de bureau. Il se justifie si vous voulez un modèle de ce niveau chez vous, sans envoyer vos données à un fournisseur. Le serveur est livré avec les logiciels installés et testés.
Est-il bon ? Son niveau, d'après Thinking Machines
La fiche le compare à d'autres gros modèles ouverts, pas à Qwen3.8-27B ni à Gemma 4 12B : nous ne pouvons donc pas le situer face à eux avec des chiffres publiés. Face aux modèles de sa catégorie, il ressort très bien sur le travail de bureau (juridique, finance, tâches d'entreprise) et sur le peu d'inventions. En code pur, DeepSeek-V4.1-Flash-1017 reste devant. Nous avons consacré un article à DeepSeek-V4.1-Flash-1017 et un autre à MiniMax-M3.1-Flash.
| Test (scores publiés par Thinking Machines) | Inkling 2 Small | DeepSeek V4.1 Flash-1017 | MiniMax M3.1 Flash | GLM-5.3-Flash |
|---|---|---|---|---|
| JobBench (tâches de bureau) | 70,5 % | 68,5 % | 67,5 % | 60,7 % |
| Finance Agent (agent en finance) | 67,5 % | 62,9 % | 58,8 % | 60,6 % |
| Harvey LAB (travail juridique) | 21,7 % | 14,2 % | 7,5 % | 10,4 % |
| Réponses sans invention (AA-Omniscience) | 73,3 % | 35,9 % | 6,3 % | 61,7 % |
| Global-MMLU-Lite (plusieurs langues) | 91,0 % | 90,4 % | 78,5 % | 89,0 % |
| DeepSWE v1.1 (code) | 72,1 % | 77,0 % | 73,7 % | 63,4 % |
Scores donnés par Thinking Machines, mesurés avec ses propres réglages : un ordre de grandeur, pas un classement indépendant. « Réponses sans invention » correspond au taux de non-hallucination d'AA-Omniscience v1.1.
La licence, avant tout usage en entreprise
Apache 2.0
Le modèle est publié sous licence Apache 2.0 : usage commercial, modification et redistribution sont permis.
Mentions et politique d'usage
En cas de redistribution, il faut garder la licence et les mentions de droits d'auteur. Thinking Machines publie aussi une politique d'usage acceptable, à lire avant un déploiement.
Résumé de la licence indiquée sur la fiche du modèle, qui seule fait foi. Ce n'est pas un avis juridique.
Faut-il vraiment un modèle de cette taille ?
Souvent, non. Pour un assistant interne ou la recherche dans vos documents, un modèle de 20 à 30 milliards de paramètres tient sur une seule carte, pour un budget très inférieur. Inkling 2 Small se justifie pour des agents qui traitent des dossiers complexes, quand la qualité et la fiabilité des réponses priment sur le coût.
| Machine | Mémoire GPU | Prix HT |
|---|---|---|
| CoreIA RTX 5060 Ti | 16 Go | 1 724 € |
| CoreIA RTX 5090 | 32 Go | 9 403 € |
Quel modèle pour votre usage ?
Dites-nous ce que vous voulez faire tourner. Nous vous disons quelle machine, et si un modèle plus petit suffit. Devis gratuit, sans engagement.
Questions fréquentes
Quelle mémoire GPU faut-il pour Inkling 2 Small ?
Au moins 500 Go pour sa version native en 4 bits (NVFP4), et au moins 800 Go pour la version en 8 bits, selon Thinking Machines.
Pourquoi « Small » s'il a 594 milliards de paramètres ?
C'est la petite version de la gamme de son éditeur. Elle reste un très gros modèle : 594 milliards de paramètres au total, dont 17 milliards actifs pour chaque mot.
Peut-on le faire tourner sur une seule carte graphique ?
Non. Même la RTX PRO 6000, avec 96 Go, en est loin. Il faut un serveur avec au moins 6 RTX PRO 6000, comme notre Serveur IA EPYC 8 GPU avec des cartes en option.
Est-il meilleur que DeepSeek-V4.1-Flash-1017 ?
D'après les scores de Thinking Machines, il fait mieux en travail de bureau, en juridique, en finance et invente moins de réponses. DeepSeek-V4.1-Flash-1017 reste devant en code.
Peut-on l'utiliser dans une entreprise ?
Oui. La licence Apache 2.0 permet l'usage commercial. Gardez la licence et les mentions en cas de redistribution, et lisez la politique d'usage de Thinking Machines.
Quel moteur utiliser pour le servir ?
Thinking Machines publie des recettes pour SGLang, vLLM, TokenSpeed et Unsloth.
Quelle vitesse peut-on en attendre ?
Nous n'avons pas mesuré ce modèle sur nos machines et n'annonçons donc aucune vitesse.
Sources : Thinking Machines, fiche d'Inkling 2 Small sur Hugging Face ; licence Apache 2.0 ; Thinking Machines, politique d'usage acceptable. Relevé du 13 novembre 2026.