Workstation KI zu Hause 2026: Der komplette Guide zum Bau deiner KI-Station für zu Hause
Möchten Sie 2026 eine KI-Workstation für zu Hause zusammenstellen? Dann sind Sie hier genau richtig. Open-Source-Modelle haben das Frontier-Niveau erreicht, Tools wie Ollama und Open WebUI sind für jeden technisch versierten Benutzer zugänglich geworden, und Consumer-Hardware – RTX 5060 Ti 16 GB, RTX 5090, GB10 Mini-Supercomputer – ermöglicht es, Llama 4, Qwen 3.5 und DeepSeek V4 direkt von Ihrem Heimarbeitsplatz aus auszuführen.
Dieser Leitfaden beschreibt Konfigurationen, Budgets und Hardware-Entscheidungen für eine persönliche oder freiberufliche KI-Workstation für zu Hause, ohne Cloud, ohne Abonnement und mit einer schnellen Amortisation.
Warum 2026 eine KI-Workstation für zu Hause zusammenstellen?
Sofortige Rentabilität vs. Cloud
Eine RTX 5090 für ~2.000€ zahlt die äquivalente A100 / H100 Cloud in 120 bis 200 Stunden Nutzung ab. Bei 8 Stunden/Tag, 5 Tagen/Woche ist der ROI in 4 bis 6 Monaten erreicht – danach läuft Ihre Workstation 3 bis 5 Jahre lang kostenfrei.
Ihre Daten bleiben bei Ihnen
Vertrauliche Geschäftsideen, Kundendaten von Freiberuflern, persönliche F&E-Projekte, proprietärer Code: Alles bleibt auf Ihrem Computer. Kein Risiko von Datenlecks, keine versteckten Nutzungsrichtlinien, keine Überwachung durch einen Cloud-Anbieter.
Null Latenz, 24/7 Verfügbarkeit
Keine Warteschlangen, keine Quoten, kein GPU-Abschalten um Mitternacht. Ihre Workstation ist jederzeit einsatzbereit. Sie starten ein Fine-Tuning um 2 Uhr morgens, und es läuft ununterbrochen bis zum Morgen.
Völlige Freiheit beim Experimentieren
Keine Nutzungsgrenzen, keine Prompt-Zensur, Root-Zugriff, freie Wahl der Frameworks (PyTorch, TensorFlow, vLLM, llama.cpp, ComfyUI…). Sie testen, was Sie wollen, ohne um Erlaubnis zu fragen.
Vielseitigkeit – nicht nur für KI
Eine moderne KI-Workstation betreibt auch die neuesten AAA-Spiele in 4K, 8K-Videobearbeitung, 3D-Rendering mit Blender, OBS-Streaming – die RTX 5090 32 GB GDDR7 ist auch die beste Gaming-GPU 2026.
Offline – funktioniert ohne Internet
ADSL-Ausfall, Umzug, Telearbeit in einem schlecht versorgten Gebiet: Ihre KI bleibt betriebsbereit. Eine echte digitale Autonomie.
KI-Workstation für zu Hause vs. Cloud: Der echte Kostenvergleich
| Kriterium | Cloud-GPU (AWS/Azure) | KI-Workstation für zu Hause |
|---|---|---|
| Stundensatz A100 / H100 | ~32 €/h kontinuierlich (~23.000 €/Monat) | 0 € nach Amortisation |
| Anfangsinvestition | 0 € | 1.700 € bis 8.000 € |
| Amortisationspunkt | — | 4 bis 6 Monate (8h/Tag Nutzung) |
| Datenvertraulichkeit | Daten beim Anbieter | 100% lokal |
| GPU-Latenz | Variabel (~5-50 ms) | Null (direkt über PCIe) |
| GPU-Verfügbarkeit | Je nach Instance-Bestand | Jederzeit 100% |
| Quoten / Limits | Ja (Rate Limit, Tokens) | Keine |
| Über 3 Jahre (moderate Nutzung) | 15.000 – 60.000 € | 2.000 – 8.000 € + Strom |
Der kritische Faktor: VRAM
Um ein LLM lokal auszuführen, ist das wichtigste Kriterium der Videospeicher (VRAM). Die Inferenz wird durch die Speicherbandbreite begrenzt – die GPU verbringt die meiste Zeit damit, Modellgewichte zu laden, nicht mit Berechnungen.
| VRAM | Kompatible Modelle (Q4) | Art der Nutzung | GPU-Typ |
|---|---|---|---|
| 8 GB | 7-9B (Llama 3.1 8B, Qwen3 8B) | Entdeckung, persönlicher Chatbot | RTX 5060 8 GB |
| 12 GB | 13B-17B MoE (Llama 4 Scout) | Regelmäßige Nutzung, Experimente | RTX 5070 12 GB |
| 16 GB ⭐ Sweet Spot 2026 | 14B dicht (Qwen 3.5 14B, Phi-4) | Profi-Workstation / Freiberufler | RTX 5060 Ti / 5070 Ti 16 GB |
| 24 GB | 26-32B (Gemma 4, Qwen 3.5 32B) | Fortgeschrittene Modelle, Code | RTX 4090 24 GB (gebraucht) |
| 32 GB | 70B in Q4 (Llama 3.3 70B) | Ernsthaftes Fine-Tuning, GPT-4-Qualität | RTX 5090 32 GB |
| 48 GB | 70B FP16 oder größerer Kontext | Forschung, Multi-Modell | RTX 6000 Ada 48 GB |
| 128 GB Unified | 200B+ (DeepSeek V4, Llama 4) | Mini-Supercomputer-Format | NVIDIA GB10 (Ascent GX10) |
| 96-192 GB (Multi-GPU) | Alle Modelle, schweres Fine-Tuning | Profi / Heim-Mini-Lab | 2× RTX 5090 oder 2× RTX 6000 Pro |
Die Komponenten einer guten KI-Workstation für zu Hause im Jahr 2026
GPU — die wichtigste Komponente
Die GPU macht 50 bis 70% des Budgets einer KI-Workstation aus und bestimmt direkt die Größe der Modelle, die Sie ausführen können. Im Jahr 2026 ist die RTX 5090 32 GB die absolute Referenz für den Consumer-Bereich – 1.792 GB/s Speicherbandbreite, GDDR7, Blackwell. Für kleinere Budgets bietet die RTX 5060 Ti 16 GB das beste Preis-Leistungs-Verhältnis: 16 GB reichen für 14B-Modelle in Q4_K_M.
CPU — weniger kritisch, aber unerlässlich
Für reine GPU-Inferenz reicht jede moderne CPU aus. Für Fine-Tuning, RAG oder mehrstufige Pipelines ist ein AMD Ryzen 7 7800X3D, Ryzen 9 9900X oder Ryzen 9 9950X3D ideal. Für Multi-GPU-Konfigurationen und HPC zu Hause wird der Threadripper PRO relevant (bis zu 96 Kerne und 2 TB ECC-RAM).
System-RAM — mindestens 32 GB DDR5
Das Mindeste im Jahr 2026 sind 32 GB DDR5. Mit 64 GB gewinnen Sie an Komfort (RAG auf großen Datenbanken, Multi-Modell, Inferenz-Batches). Für ernsthafte Forschungsaufgaben oder intensives Fine-Tuning wird 128 GB ECC DDR5 zum Standard. Die Frequenz ist ebenfalls wichtig: DDR5-6000 bietet +15-25% mehr Leistung beim CPU-Offloading im Vergleich zu DDR4-3200.
SSD NVMe Gen 4 — schnell und reichlich
Ein 14B-Modell wiegt 8-9 GB, ein 70B-Modell 40 GB, und eine komplette Sammlung erreicht schnell über 200 GB. Rechnen Sie mit mindestens 1 TB NVMe Gen 4, 2 TB für ernsthafte Benutzer, 4 TB für Fine-Tuning-Datensätze.
Netzteil — überdimensioniert und zuverlässig
Eine RTX 5090 verbraucht in Spitzenzeiten bis zu 575 W. Mit einem Ryzen 9 und dem restlichen System rechnen Sie mit mindestens 1.000 W 80+ Gold für Mono-GPU und 2.000 W Platinum für Bi-GPU-Konfigurationen. Vermeiden Sie billige Netzteile – Seasonic, Corsair, MSI sind weiterhin die sicheren Werte.
Kühlung — Stille und Stabilität rund um die Uhr
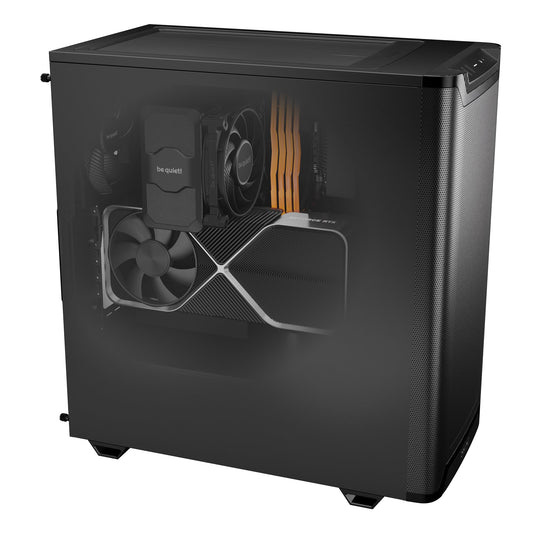
KI-Workloads laufen oft stundenlang unter Dauerlast. Mindestens 360 mm AIO-Wasserkühlung für leistungsstarke CPUs. Gehäuse mit hohem Luftstrom (Fractal Design, be quiet!), um thermisches Throttling zu vermeiden.
Unsere Radiance KI-Workstations – in der Provence montiert, EU-weit geliefert
Jede Radiance Workstation wird in Auriol (13390) von Hand zusammengebaut, vor dem Versand unter Last getestet und betriebsbereit geliefert. Ollama + Open WebUI auf Wunsch vorinstalliert, Modelle nach Wahl heruntergeladen. Sie starten Ihren PC, Sie unterhalten sich in weniger als 2 Minuten mit Ihrer KI.

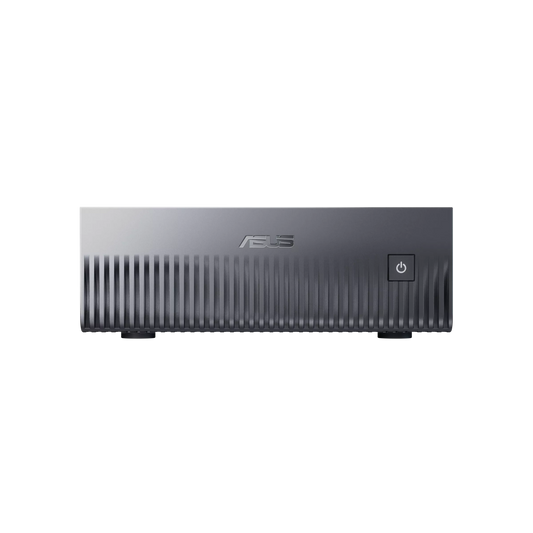
Mini-KI-Workstation NVIDIA GB10 — ASUS Ascent GX10
✅ Llama 4 Maverick FP16 · DeepSeek V4 Flash FP16 · Modelle 200B+
Die kompakteste Heim-KI-Workstation auf dem Markt – Buchformat, leise, benötigt nur eine Standardsteckdose. 128 GB Unified Memory ermöglichen das Laden von Modellen, die selbst eine RTX 5090 (32 GB) nicht halten kann. GB10-Architektur: CPU und GPU über NVLink-C2C mit 900 GB/s verbunden.
Betriebsbereit geliefert · DGX OS · natives Ollama
Diesen Server konfigurieren →
KI-Workstation CoreAI 16 — RTX 5060 Ti 16 GB
✅ Qwen 3.5 14B · Llama 4 Scout 17B · Phi-4 14B · Mistral Medium 3.5
Gemessene Geschwindigkeit: 40-70 Token/Sekunde
Der ideale Einstiegspunkt für eine erste Heim-KI-Workstation. 16 GB GDDR7 – der Sweet Spot 2026 – für 14B-Modelle auf der GPU ohne Überlauf. Kompakter und leiser Tower für das Home Office. Skalierbare AM5 DDR5-Plattform (Upgrade auf Ryzen 9 später möglich).
Gehäuse, RAM, SSD vollständig anpassbar
Diese Workstation konfigurieren →
KI-Workstation CoreAI 32 — RTX 5070 Ti 16 GB
✅ Qwen 3.5 32B · Gemma 4 26B · Qwen2.5-Coder 32B (92,7% HumanEval)
Gemessene Geschwindigkeit: 25-45 Token/Sekunde
Die vielseitige Station für freiberufliche Entwickler und Kreative. 1,9-mal höhere Speicherbandbreite als die RTX 5060 Ti für 26-32B-Modelle. Ryzen 9 9900X (12 Kerne) für RAG-Pipelines, n8n, ComfyUI und intensive KI- und Büro-Multitasking.
Ideal für KI-Entwickler, Freiberufler, Content Creator
Diese Workstation konfigurieren →
KI-Workstation CoreAI 64 — RTX 5090 32 GB
✅ Llama 3.3 70B Q4 · Qwen 3.5 72B Q4 · DeepSeek V4 Flash
Gemessene Geschwindigkeit: 15-30 Token/s bei 70B · Auch top beim 4K-Gaming
Die beste Consumer-KI-Workstation im Jahr 2026. Rekord-Speicherbandbreite (1.792 GB/s) für 70B-Modelle in Q4 vollständig auf der GPU – fast GPT-4o-Qualität lokal. Der 9950X3D glänzt auch beim Gaming und der Inhaltserstellung: eine Maschine, zwei Premium-Nutzungen.
LoRA Fine-Tuning möglich · natives 4K-Gaming
Diese Workstation konfigurieren →
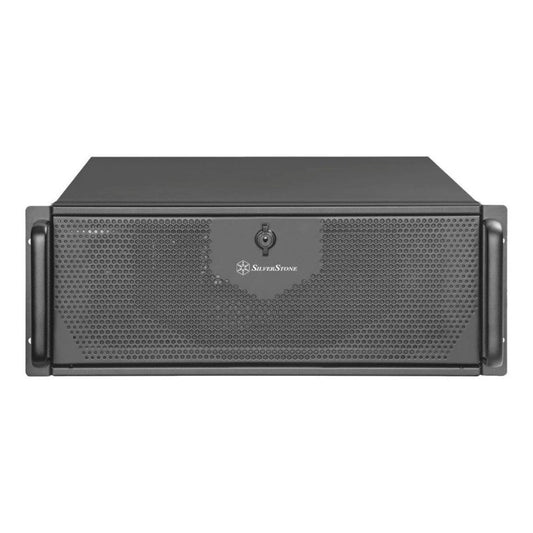
Radiance CoreAI Rack — 2× RTX 5090 (64 GB VRAM)
✅ Llama 3.3 70B FP16 · Qwen 3.5 235B Q4 · LoRA Fine-Tuning 70B · Gleichzeitige Multi-Modell-Nutzung
Das KI-Mini-Lab für zu Hause. 64 GB VRAM insgesamt, um mehrere Modelle parallel laufen zu lassen oder sie in nativer Präzision zu laden. Ideal für unabhängige Forscher, erfahrene KI-Freelancer oder Kreative, die Multi-Modelle (LLM + Stable Diffusion + simultanes TTS) nutzen möchten.
Maßgeschneidert · 4U Rack · Ernsthaftes Fine-Tuning
Dieses Rack konfigurieren →
KI Workstation Pro Ultra — Threadripper PRO
✅ Alle Modelle · Ernsthaftes Fine-Tuning · Verteiltes Training · HPC zu Hause
Für fortgeschrittene Benutzer, die ein echtes Mini-Rechenzentrum zu Hause möchten. Threadripper PRO sTR5 Plattform erweiterbar auf bis zu 96 Kerne und 2 TB ECC RAM. Ideal für unabhängige Forscher, Agentur-KI-Entwickler oder sehr fortgeschrittene Enthusiasten, die eine zukunftssichere Maschine für 5+ Jahre wünschen.
Maßgeschneidert · Individuelles Angebot · Installation möglich
Angebot anfragen →Welche Home AI Workstation passt zu Ihrem Profil?
KI-/Data-Science-Student
Lernen von Frameworks (PyTorch, Hugging Face), Experimentieren mit 7-14B-Modellen, Kursprojekte. Die CoreAI 16 RTX 5060 Ti 16 GB (~1.700€) reicht für 95% der studentischen Bedürfnisse aus.
Freiberuflicher Entwickler / KI-Agentur
Code-Unterstützung (Qwen2.5-Coder 32B), Prototypen für Kunden, schnelle Demos. Die CoreAI 32 RTX 5070 Ti (~2.400€) oder die CoreAI 64 RTX 5090 (~6.000€) je nach Aktivitätslevel.
Content Creator / Digital Artist
Stable Diffusion, Flux, ComfyUI, Videogenerierung (LTX-Video, Hunyuan), TTS. Die RTX 5090 ist unschlagbar — CoreAI 64 RTX 5090 (~6.000€). Bonus: auch top für 4K/8K-Bearbeitung.
Unabhängiger Forscher / Fortgeschrittener Enthusiast
Ernsthaftes Fine-Tuning, Experimente mit 70B+-Modellen, Reproduktion von Papers. Rack 2× RTX 5090 (~11.000€) für 64 GB VRAM oder GB10 ASUS Ascent GX10 für 200B+-Modelle.
Selbstständiger / Berater, der sensible Daten verarbeitet
Anwalt, Buchhalter, Arzt, Berater: Ihre Kundendaten dürfen nicht auf ChatGPT landen. CoreAI 16 oder 32 RTX 5060/5070 Ti (~1.700-2.400€) + Open WebUI = komplette DSGVO-Lösung.
Gamer + KI-Neugieriger
Sie wollen eine Maschine, die alles kann: AAA 4K-Spiele, Streaming und lokale KI parallel. Die CoreAI 64 RTX 5090 (~6.000€) ist die beste Consumer-Maschine 2026, für alle Anwendungen.
Empfohlener Software-Stack für eine Home AI Workstation im Jahr 2026
- OS: Ubuntu 24.04 LTS (optimal für CUDA) oder Windows 11 Pro + WSL2 (Kompromiss für gemischte Nutzung)
- Treiber / Laufzeitumgebung: NVIDIA Treiber 570+, CUDA Toolkit 12.8+, cuDNN 9.x
- Containerisierung: Docker + NVIDIA Container Toolkit (isolierte Workloads)
- Lokale Inferenz: Ollama (einfacher Chatbot), vLLM 0.6+ (Produktions-API-Server), llama.cpp (CPU-Offload)
- Benutzeroberfläche: Open WebUI (Web-Frontend wie ChatGPT, natives RAG)
- Bildgenerierung: ComfyUI + Flux / SD3.5 Modelle
- ML Frameworks: PyTorch nightly (Blackwell-Unterstützung), Hugging Face Transformers, Diffusers
- Umgebungen: Miniforge + mamba (projektisoliert)
- Sicherheit: UFW + fail2ban + LUKS Festplattenverschlüsselung + SSH key-only
Häufig gestellte Fragen — Home AI Workstation
Welches Budget für eine Home AI Workstation im Jahr 2026?
Um ernsthaft mit 14B-Modellen (Qwen 3.5, Llama 4 Scout) zu beginnen, rechnen Sie mit ~1.700 bis 2.400€ (RTX 5060 Ti 16 GB oder RTX 5070 Ti). Für 70B-Modelle und absolute Vielseitigkeit (KI + 4K-Gaming + Kreation) ~6.000€ (RTX 5090 32 GB). Für ein Mini-Lab zu Hause 11.000 bis 20.000€.
Sollte man wirklich über einen Assembler gehen oder selbst zusammenbauen?
Wenn Sie sehr technisch versiert sind, können Sie beim Selbstbau 5-10% sparen. Aber Sie verlieren die Systemgarantie, den integrierten Service und die Zeit für Tests. Ein spezialisierter Assembler wie Radiance Systems liefert eine Maschine, die vor dem Versand mehrere Stunden unter KI-Last getestet wurde, mit bereits installierten Ollama und Modellen. Für den professionellen Einsatz oder wenn Ihre Zeit etwas wert ist, ist dies sehr rentabel.
Wie hoch ist der Stromverbrauch einer Home AI Workstation?
Eine CoreAI 16 RTX 5060 Ti verbraucht ~250 W unter KI-Last (~30€/Jahr für 2h/Tag bei 0,20€/kWh in Deutschland). Eine CoreAI 64 RTX 5090 erreicht ~700 W unter Last (~80€/Jahr). Das Mini GB10 bleibt trotz 128 GB Speicher unter 250 W. Deutlich günstiger als ein Cloud-GPU-Abonnement.
Macht eine AI Workstation zu Hause Lärm?
Mit einer guten Kühlung (AIO 360mm Wasserkühlung, leises be quiet! oder Fractal Design Gehäuse) läuft eine KI-Workstation unter Last mit 35-40 dB — vergleichbar mit einem Büro-PC. Das Mini GB10 ist passiv/nahezu geräuschlos konzipiert. Für 4U Rack-Konfigurationen mit zwei GPUs ist es besser, sie in einem speziellen Raum zu installieren.
Kann man Stable Diffusion / Flux zusätzlich zu einem LLM auf derselben Maschine ausführen?
Ja, das ist sogar einer der großen Vorteile einer Home AI Workstation. Mit 16 GB VRAM können Sie abwechseln; mit 32 GB (RTX 5090) können Sie ein 14B LLM + ComfyUI gleichzeitig laden. Für echte parallele Multi-Modell-Nutzung ist die Rack-Konfiguration mit 2× RTX 5090 (64 GB insgesamt) ideal.
Wie greife ich remote auf meine AI Workstation zu?
Mehrere Optionen: SSH (sicherer Tunnel für Entwickler), Tailscale (ultra-einfaches Mesh-VPN, Zugriff von überall), Open WebUI über Cloudflare Tunnel (verschlüsselte Weboberfläche von Ihrem Telefon). All dies kann bei Lieferung vorkonfiguriert werden.
Nimmt meine AI Workstation viel Platz ein?
Ein Mid-Tower (CoreAI 16/32/64) misst etwa 45×22×46 cm — vergleichbar mit einem High-End-Büro-PC. Das GB10 ASUS Ascent GX10 passt auf eine Schreibtischunterlage (15×15 cm). Die 4U Rack-Konfigurationen sind größer, können aber in einem Schrank oder einem Technikraum installiert werden.