PC für Ollama 2026: Welche Hardware benötigen Sie, um Ihre LLMs lokal auszuführen?
Ollama hat sich 2026 zum Referenztool für die lokale Ausführung von LLMs entwickelt — ein einziger Befehl zum Herunterladen eines Modells, eine OpenAI-kompatible API auf localhost:11434 und die Möglichkeit, Llama 4, Qwen 3.5, DeepSeek V4 oder Gemma 4 direkt auf dem eigenen Rechner laufen zu lassen. Doch welcher PC ist nötig, um tatsächlich nutzbare Leistungen zu erzielen? Dieser Leitfaden beantwortet die Frage präzise, mit realen Benchmarks und getesteten Hardware-Empfehlungen.
Was ist Ollama und warum nutzt es 2026 jeder?
Ollama ist eine Open-Source-LLM-Laufzeitumgebung, die KI-Modelle lokal herunterlädt, ausführt und bereitstellt — vollständig auf Ihrem Rechner, ohne Cloud-Verbindung. Ihre Verbreitung ist 2026 aus drei Gründen explodiert:
- Ein Befehl zum Starten. Keine komplexe Konfiguration, kein Verwalten von Gewichten, Quantisierung oder Kompilieren von Laufzeitumgebungen.
-
OpenAI-kompatible API. Jede Anwendung, die für ChatGPT entwickelt wurde, kann auf Ollama umgestellt werden, indem einfach die URL geändert wird —
localhost:11434stattapi.openai.com. -
Bibliothek von über 500 Modellen. Llama 4 Scout, Qwen 3.5, DeepSeek V4, Gemma 4, Mistral, Phi-4, Qwen2.5-Coder — alle mit einem einzigen
ollama pull-Befehl verfügbar.
Die Installation ist einzeilig:
curl -fsSL https://ollama.com/install.sh | sh
ollama pull qwen3:14b
ollama run qwen3:14b
In weniger als 5 Minuten haben Sie ein funktionsfähiges lokales LLM — zugänglich über Ihren Browser (via Open WebUI), Ihren Code-Editor oder jede Anwendung über die REST-API.
Der kritische Faktor für Ollama: der VRAM
Ollama lädt die Modellgewichte in den GPU-Speicher. Passt alles in den VRAM, erreichen Sie 40 bis 80 Tokens/Sekunde auf einer RTX 5060 Ti 16 GB. Muss das Modell in den System-RAM ausgelagert werden, bricht die Leistung ein:
Fazit: Es ist besser, ein kleineres Modell zu wählen, das vollständig in den VRAM passt, als ein großes Modell, das ausgelagert werden muss. Ein Qwen 3.5 14B mit 60 tok/s ist nützlicher als ein Llama 3.3 70B, das mit 4 tok/s ruckelt.
Benötigter VRAM je nach Ollama-Modell (Q4_K_M, Mai 2026)
| GPU-VRAM | Kompatible Modelle | Beispiele 2026 | Ca. Geschwindigkeit |
|---|---|---|---|
| 5-8 GB | Bis zu 9B | Llama 3.1 8B, DeepSeek-R2 8B, Qwen3 8B, Gemma 3 4B | 40-90 tok/s |
| 12 GB | Bis zu 17B MoE | Llama 4 Scout 17B, Gemma 3 12B | 30-50 tok/s |
| 16 GB ⭐ Sweet Spot | 13B-14B dicht / 17B MoE | Qwen 3.5 14B, Mistral Medium 3.5, Phi-4 14B | 40-70 tok/s |
| 20 GB | Bis zu 32B | Qwen2.5-Coder 32B, DeepSeek-R1 32B | 25-40 tok/s |
| 24 GB | Bis zu 27B komfortabel | Gemma 4 26B QAT (85 tok/s gemessen) | 30-60 tok/s |
| 32 GB (RTX 5090) | Bis zu 70B in Q4 | Llama 3.3 70B (86.0 MMLU), Qwen 3.5 72B | 15-30 tok/s |
| 48 GB+ (Multi-GPU) | 70B FP16 oder Q5/Q6 | Llama 3.3 70B FP16 mit 32K Kontext | 10-20 tok/s |
| 128 GB Unified (GB10) | Modelle 200B+ | DeepSeek V4 Flash FP16, Llama 4 Maverick | 20-40 tok/s |
Quellen: Echte Ollama-Benchmarks von Morph (April 2026), glukhov.org (RTX 4080 16 GB, März 2026), LocalAIMaster (März 2026). VRAM gemessen bei 8K-19K Kontext mit Q4_K_M-Quantisierung. Die tatsächlichen Werte variieren je nach geladenem Kontext.
Die besten Ollama-Modelle im Mai 2026 nach Kategorie
| Kategorie | Empfohlenes Modell | Ollama-Befehl | VRAM |
|---|---|---|---|
| Allround-Modell | Llama 4 Scout 17B | ollama pull llama4:scout |
~10 GB |
| Französisch / mehrsprachig | Qwen 3.5 14B | ollama pull qwen3.5:14b |
~10 GB |
| Reine Geschwindigkeit (85 tok/s) | Gemma 4 26B QAT | ollama pull gemma4:26b |
~14 GB |
| Code ⭐ #1 Open Source | Qwen2.5-Coder 32B | ollama pull qwen2.5-coder:32b |
~20 GB |
| Mathematisches/logisches Denken | DeepSeek-R2 8B | ollama pull deepseek-r2:8b |
~5 GB |
| MINT / Strukturierte Analyse | Phi-4 14B (80.4% MATH) | ollama pull phi4 |
~10 GB |
| Klein / leicht | Llama 3.1 8B (111M+ Downloads) | ollama pull llama3.1:8b |
~5 GB |
| Maximale Qualität | Llama 3.3 70B (86.0 MMLU) | ollama pull llama3.3:70b |
~40 GB |
Jenseits der GPU: Was für Ollama auch zählt
System-RAM (DDR5 >> DDR4)
Wenn Ihr Modell in den System-RAM ausgelagert wird, hängt die Geschwindigkeit direkt von der Speicherbandbreite ab. DDR5-6000 bietet 15-25% mehr Leistung als DDR4-3200 im CPU-Offloading-Modus. Für Ollama sollten Sie mindestens 32 GB DDR5 auf einer AM5-Plattform bevorzugen.
Schnelle NVMe-SSD
Ollama-Modelle wiegen zwischen 5 GB (Llama 3.1 8B) und 40 GB (Llama 3.3 70B). Eine NVMe Gen 4 SSD lädt ein 14B-Modell beim ersten ollama run in 5-8 Sekunden. Auf einer SATA-SSD dauert es 30-60 Sekunden.
CPU und Threads
Für reine GPU-Inferenz spielt die CPU kaum eine Rolle. Aber sobald CPU-Offloading oder RAG (Retrieval Augmented Generation) ins Spiel kommt, macht ein Ryzen 7 oder 9 mit 12-16 Kernen einen Unterschied. AVX-512 (Intel 12. Gen+, AMD Zen 4+) beschleunigt die CPU-Inferenz um 10-20%.
Wichtige Ollama-Befehle
# Ollama installieren (Linux/macOS)
curl -fsSL https://ollama.com/install.sh | sh

# Modell herunterladen und starten
ollama pull qwen3.5:14b
ollama run qwen3.5:14b

# Installierte Modelle auflisten
ollama list

# Modell stoppen (VRAM freigeben)
ollama stop qwen3.5:14b

# GPU/CPU-Nutzung anzeigen
OLLAMA_DEBUG=1 ollama run llama3.1:8b "test" 2>&1 | grep "layers"

# Eine genaue Anzahl von GPU-Schichten erzwingen
ollama run llama3.1:8b --gpu-layers 28
Häufige Fehler vermeiden
- Q2_K wählen, um ein großes Modell unterzubringen — führt zu starker Qualitätsminderung. Ein 34B-Modell in Q6_K ist besser als ein 70B-Modell in Q2_K.
- KV-Cache ignorieren — ein 8B-Modell mit 32K Kontext benötigt ~4,5 GB zusätzlichen Speicher für den Aufmerksamkeits-Cache. Lassen Sie 2-4 GB VRAM-Puffer.
-
Mehrere Modelle gleichzeitig laden — Ollama behält sie standardmäßig im VRAM. Verwenden Sie
ollama stop, um sie freizugeben. - RAM unterschätzen — mindestens 32 GB DDR5 für ernsthaften Gebrauch. 64 GB für 30B+-Modelle mit CPU-Offloading.
Unsere für Ollama optimierten PCs — vorkonfiguriert mit Ollama + Open WebUI
Radiance Systems entwickelt Workstations, die auf lokale LLM-Inferenz spezialisiert sind. Jede Maschine wird mit Ollama und Open WebUI vorinstalliert und auf Wunsch konfiguriert geliefert, mit den Modellen Ihrer Wahl bereits heruntergeladen. Sie starten Ihren PC und kommunizieren in weniger als 2 Minuten mit Ihrer KI.

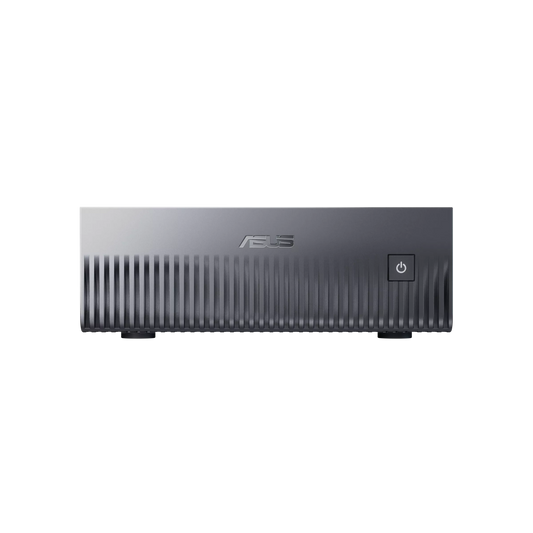
Mini IA-Server NVIDIA GB10 — ASUS Ascent GX10
✅ Llama 4 Maverick FP16 · DeepSeek V4 Flash FP16 · Modelle bis zu 200B Parameter
Das einzige Desktop-System, das Modelle ausführen kann, die selbst eine RTX 5090 nicht im VRAM halten kann. 128 GB Unified Memory, GPU und CPU über NVLink-C2C mit 900 GB/s verbunden. Ideal für ein Büro, das maximale Kapazität in einem ultrakompakten und leisen Format benötigt.
Lieferung sofort einsatzbereit · DGX OS · natives Ollama
Diesen Server konfigurieren →
Radiance PC CoreAI 16 — RTX 5060 Ti 16 GB
✅ Qwen 3.5 14B · Mistral Medium 3.5 · Llama 4 Scout 17B · Phi-4 14B
Gemessene Geschwindigkeit: 40-70 Tokens/Sekunde
Der Sweet Spot 2026 für Ollama. 16 GB GDDR7, um die 14B-Modelle vollständig auf der GPU ohne CPU-Offloading laufen zu lassen. AM5 DDR5-Plattform für RAG-Pipelines. Idealer Einstiegspunkt für einen Freiberufler.
Ollama + Open WebUI auf Anfrage vorinstalliert
Diese Workstation konfigurieren →
Radiance PC CoreAI 32 — RTX 5070 Ti 16 GB
✅ Qwen2.5-Coder 32B (92,7% HumanEval) · Gemma 4 26B · DeepSeek-R1 32B
Gemessene Geschwindigkeit: 25-45 Tokens/Sekunde
Für anspruchsvolle Entwickler und Profis. 1,9-mal höhere Speicherbandbreite als die RTX 5060 Ti, ideal für 27B-32B-Modelle. Der Ryzen 9 9900X verwaltet RAG-Pipelines und n8n-Orchestrierung parallel.
Modelle auf Anfrage vorab heruntergeladen (Qwen3.5, Mistral, DeepSeek)
Diese Workstation konfigurieren →
Radiance PC CoreAI 64 — RTX 5090 32 GB
✅ Llama 3.3 70B Q4 (86.0 MMLU) · Qwen 3.5 72B · DeepSeek V4 Flash
Gemessene Geschwindigkeit: 15-30 Tokens/Sekunde auf 70B
Die beste Consumer-GPU für Ollama im Jahr 2026. 1.792 GB/s Speicherbandbreite — Rekord auf dem Consumer-Markt. Llama 3.3 70B Q4 vollständig auf der GPU, nahezu gleiche Leistung wie GPT-4o bei den meisten Aufgaben.
Leichtes Fine-Tuning möglich · LoRA kompatibel
Diese Workstation konfigurieren →
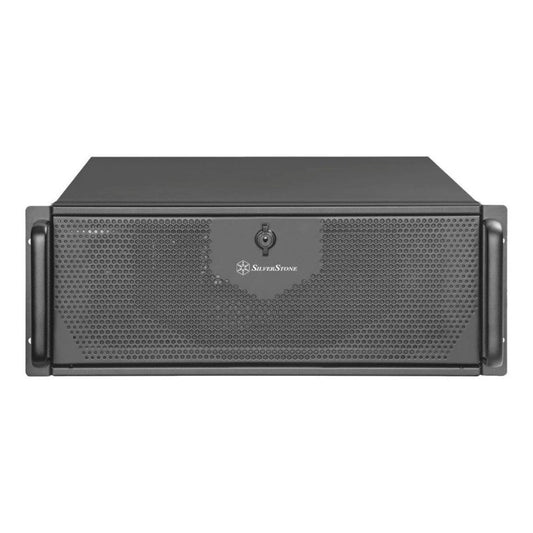
Radiance CoreAI Rack — 2× RTX 5090 (64 GB VRAM)
✅ Llama 3.3 70B FP16 · Qwen 3.5 235B Q4 · Simultane Multi-GPU-Inferenz
Für Teams von 5 bis 20 Benutzern, die einen Ollama-Server teilen. Konkurrierende Inferenz auf zwei unabhängigen GPUs — jeder Benutzer hat seinen eigenen dedizierten Stream. Ideal für Büros mit mehreren Mitarbeitern.
Maßgeschneidert · 4U Rack · Ollama Multi-Tenant Server
Dieses Rack konfigurieren →
CoreAI 128 Rack — 2× RTX 6000 PRO Blackwell (192 GB ECC)
✅ Alle Ollama-Modelle in nativer Präzision · Fine-Tuning 70B+ · 24/7 Produktion
Professionelle GPUs mit ECC-Speicher für den kontinuierlichen Betrieb. 192 GB ECC VRAM ermöglichen die Ausführung der größten Open-Source-Modelle in nativer Präzision (FP16). Maximale Zuverlässigkeit für kritische Umgebungen.
Vor-Ort-Installation möglich · Dedizierter Support
Dieses Rack konfigurieren →
Radiance PC Pro AI Ultra Threadripper
✅ Verteiltes Training · Massive RAG-Pipelines · HPC · Intensives Fine-Tuning
Die ultimative Workstation für anspruchsvolle Produktionsumgebungen. Erweiterbare Threadripper PRO sTR5 Plattform mit bis zu 96 Kernen und 2 TB ECC RAM. Für gemischte Lasten: Ollama + Vektor-Datenbanken + n8n Orchestrierung + Training.
Maßgeschneidert · Individuelles Angebot · Vor-Ort-Installation
Angebot anfordern →Welcher PC für Ollama passt zu Ihrem Profil?
| Profil | Konfiguration | Typisches Ollama-Modell | Budget |
|---|---|---|---|
| Entdeckung / geringe persönliche Nutzung | RTX 5060 Ti 16 GB (CoreAI 16) | Qwen 3.5 14B, Llama 4 Scout | ~1.700€ |
| Kompakte Freiberufler-Kanzlei ⭐ | ASUS Ascent GX10 (GB10) | DeepSeek V4 Flash FP16, 200B+ | ~4.000€ |
| Entwickler / Data Scientist | CoreAI 32 RTX 5070 Ti | Qwen2.5-Coder 32B, DeepSeek-R1 32B | ~2.400€ |
| 70B Modelle lokal | CoreAI 64 RTX 5090 | Llama 3.3 70B Q4 | ~6.000€ |
| Team 5-20 geteilte Benutzer | Rack 2× RTX 5090 | Llama 3.3 70B FP16, Multi-Tenant | ~11.000€ |
| Kritische 24/7 Produktion | Rack 2× RTX 6000 ECC | Alle Modelle, native FP16 | ~28.000€ |
Ollama Anwendungsfälle nach Branche
- Anwälte & Notare — Qwen 3.5 14B + Open WebUI: Vertragsanalyse, Recherche in Mandantendossiers, Aktenredaktion. Alles lokal, DSGVO-konform und berufliches Geheimnis gewahrt.
- Ärzte & Kliniken — Mistral Medium 3.5 + RAG: diktierte Berichte, Analyse von Patientenhistorien, medizinische Dokumentenbasis. Keine Daten erreichen einen Cloud-Server.
- Wirtschaftsprüfer — DeepSeek-R2 8B + Phi-4 14B: Bilanzanalyse, Anomalieerkennung, Berichtserstellung. Vertrauliche Zahlen werden niemals hochgeladen.
- Entwickler — Qwen2.5-Coder 32B + Ollama API: Code-Vervollständigung in VS Code/Cursor, Debugging, Refactoring. OpenAI-kompatible API, Integration in 3 Zeilen.
- KMU & Unternehmen — Llama 4 Scout + n8n + Vektordatenbank: interner KI-Assistent, verbunden mit Ihren Dokumenten, Prozessen, CRM. Bereitstellung im privaten Netzwerk.
Häufig gestellte Fragen — PC für Ollama
Welche GPU ist mindestens für Ollama erforderlich?
8 GB VRAM (RTX 4060, RTX 5060) reichen für 7-8B-Modelle wie Llama 3.1 8B oder DeepSeek-R2 8B aus. Der Sweet Spot 2026 sind jedoch 16 GB VRAM (RTX 5060 Ti 16 GB oder RTX 5070 Ti) – damit können Sie auf 13-14B- und 17B MoE-Modelle wie Qwen 3.5 14B, Mistral Medium 3.5 oder Llama 4 Scout zugreifen, die eine deutlich höhere Qualität bieten, für nur 200-400€ Preisunterschied bei der GPU.
Funktioniert Ollama ohne dedizierte GPU?
Ja, Ollama kann nur auf der CPU laufen. Aber die Geschwindigkeiten fallen auf 3-8 Tokens/Sekunde bei einem 7B-Modell mit einer modernen CPU – frustrierend für eine interaktive Nutzung. Eine GPU mit 8 GB+ VRAM wird dringend empfohlen für ein flüssiges Erlebnis (30+ Tokens/Sekunde).
Woher weiß ich, ob mein Modell in den VRAM passt?
Starten Sie OLLAMA_DEBUG=1 ollama run [Modell] "Test" – die Logs zeigen an, wie viele Schichten auf GPU vs. CPU geladen werden. Wenn weniger als 100% auf der GPU sind, ist Ihr Modell zu groß. Wählen Sie eine niedrigere Quantisierung (mindestens Q4_K_M) oder ein kleineres Modell.
Benötigt man Windows oder Linux für Ollama?
Beide funktionieren sehr gut. Linux (Ubuntu) bietet die beste Rohleistung und optimale CUDA-Unterstützung. Windows 11 vereinfacht die tägliche Nutzung und ist mit WSL2 für Entwickler kompatibel. Unsere Workstations werden mit dem Betriebssystem Ihrer Wahl geliefert.
Welche Schnittstelle soll mit Ollama verwendet werden?
Open WebUI ist die beliebteste Web-Oberfläche im Jahr 2026 – ChatGPT-ähnlich, über Docker einsetzbar, native RAG-Dokumentenverwaltung. LM Studio bietet eine Desktop-Alternative mit integrierter GUI. Unsere Radiance PCs können mit einer der beiden Optionen vorinstalliert geliefert werden, je nach Ihren Präferenzen.
Kann man auf diesen Ollama-PCs Fine-Tuning betreiben?
LoRA Fine-Tuning (parameter-effizient) ist ab 16 GB VRAM für 7B-8B Modelle möglich. Für ernsthaftes Fine-Tuning von 14B-32B sind 24 GB+ (CoreAI 32 oder höher) erforderlich. Für 70B+-Modelle rechnen Sie mit 48 GB+ mit Multi-GPU.