PC für LM Studio 2026: Lokale KI ohne Befehlszeile
Es gibt 2026 Dutzende von Möglichkeiten, ein LLM lokal auszuführen. Aber LM Studio ist die einzige, die keine Befehlszeilen, kein Terminal und keine YAML-Konfiguration erfordert. Es ist eine Desktop-Anwendung – Sie installieren sie wie Word, öffnen sie, suchen ein Modell, klicken und chatten. LM Studio ist zum Referenzwerkzeug für alle geworden, die lokale KI ohne den Umweg über die Entwickler-Ecke nutzen möchten.
Dieser Blog unterscheidet sich von unseren Ollama- oder ComfyUI-Anleitungen. Wir erklären nicht, wie man Python installiert. Wir sprechen nicht über Docker-Container. Wir erklären Ihnen, welchen PC Sie wählen sollten, damit LM Studio flüssig und angenehm läuft – vom ersten Klick bis zur ersten Antwort.
LM Studio 2026: Eine App, kein Entwickler-Tool
LM Studio ist eine All-in-One-Desktop-Anwendung, die für Windows, macOS und Linux verfügbar ist. Die Version 2026.4 ist die bisher ausgereifteste – hier ist, was sie einzigartig macht:
Integrierter Hugging Face Browser
Suchen und laden Sie jedes GGUF-Modell direkt in der App herunter, mit einer Echtzeit-GPU-Kompatibilitätsanzeige basierend auf Ihrem VRAM. Kein Webzugriff mehr erforderlich.
Visuelle Schicht-für-Schicht GPU-Zuweisung
Ein interaktiver Schieberegler zeigt Ihnen, wie viele Schichten auf der GPU vs. CPU liegen, mit direkter Anzeige der Geschwindigkeitsauswirkungen. Einzigartig unter allen lokalen LLM-Tools – selbst Entwickler beneiden es.
Side-by-Side Modellvergleich
Senden Sie denselben Prompt an zwei Modelle parallel und vergleichen Sie Qualität, Stil und Geschwindigkeit nebeneinander. Eine Schlüsselfunktion für Forscher und Fachleute, die das richtige Modell auswählen möchten.
OpenAI-kompatibler API-Server mit einem Klick
Aktivieren Sie einen lokalen Server auf localhost:1234 mit einem Klick – kompatibel mit der OpenAI API. Cursor, Continue.dev, Obsidian AI, jede für ChatGPT entwickelte App wechselt ohne Änderung zu Ihrem lokalen LM Studio.
Headless-Entwicklermodus (2026.4)
Neu im Jahr 2026: LM Studio kann ohne grafische Oberfläche über CLI für Server-Deployments gestartet werden. Das Beste aus beiden Welten – GUI für Benutzer, CLI für Administratoren.
Laden von LoRAs über GUI
Spezialisieren Sie Ihr Basismodell mit LoRA-Adaptern (Schreibstil, Fachgebiet) – per Drag & Drop in die Oberfläche, ohne Befehlszeile.
LM Studio oder Ollama? Der echte Vergleich
🖥️ LM Studio – Wählen Sie es, wenn...
- Sie kein Entwickler sind und das Terminal vermeiden möchten
- Sie Modelle visuell erkunden möchten
- Sie zwei Modelle nebeneinander vergleichen müssen
- Sie Parameter (Temperatur, Kontext…) über eine grafische Oberfläche anpassen
- Sie LoRAs ohne Konfiguration laden
- Sie zum ersten Mal mit lokaler KI beginnen
- Sie hauptsächlich Windows verwenden
⌨️ Ollama – Wählen Sie es, wenn...
- Sie Entwickler sind und die CLI bevorzugen
- Sie LLMs in Ihre Python-/Node.js-Skripte integrieren
- Sie die beste Rohgeschwindigkeit wünschen (+22% vs. LM Studio)
- Sie auf einem SSH-Server ohne Bildschirm bereitstellen
- Sie mehrere Benutzer oder Instanzen verwalten
- Sie einen erweiterten KV-Cache benötigen
- Sie Linux-Server nutzen
VRAM: Das einzige Kriterium, das Ihre Leistung bestimmt
LM Studio lädt Modelle in den GPU-VRAM, genau wie Ollama. Wenn das Modell vollständig in den VRAM passt: maximale Geschwindigkeit. Wenn ein Teil auf den System-RAM überläuft: drastischer Leistungsabfall. LM Studio hat einen einzigartigen Vorteil: Der GPU-Schichtregler ermöglicht es Ihnen, diese GPU/CPU-Aufteilung in Echtzeit zu visualisieren und anzupassen.
| VRAM GPU | Modelle 100% GPU (Q4) | LM Studio Geschwindigkeit | Beispiele Mai 2026 |
|---|---|---|---|
| 8 GB | Bis zu 9B | 35-60 tok/s | Llama 3.1 8B, Qwen3 8B, DeepSeek-R2 8B |
| 16 GB ⭐ Sweet Spot | 14B dicht / 17B MoE | 50-55 tok/s | Qwen 3.5 14B, Mistral Medium 3.5, Phi-4 14B |
| 24 GB | Bis zu 27B | 30-45 tok/s | Qwen 3.5 32B Q3, Gemma 4 26B QAT |
| 32 GB (RTX 5090) | Bis zu 70B Q4 | 15-25 tok/s | Llama 3.3 70B, Qwen 3.5 72B Q4 |
| 128 GB Unified (GB10) | Bis zu 200B | 20-35 tok/s | DeepSeek V4 Flash FP16, Llama 4 Maverick |
Die besten GGUF-Modelle für LM Studio – Mai 2026
| Verwendung | Empfohlenes Modell | GGUF-Format | VRAM |
|---|---|---|---|
| Vielseitige Konversation | Qwen 3.5 14B | Q4_K_M | ~10 GB |
| Schreiben und Deutsch | Mistral Medium 3.5 | Q4_K_M | ~12 GB |
| Analyse und Argumentation | DeepSeek-R2 8B | Q5_K_M | ~5 GB |
| Geschwindigkeit + Qualität ⭐ | Gemma 4 26B QAT | Q4_K_M | ~14 GB |
| Code | Qwen2.5-Coder 14B | Q4_K_M | ~10 GB |
| Mathematik / Logik | Phi-4 14B | Q4_K_M | ~10 GB |
| Leicht und schnell | Llama 4 Scout 17B | Q4_K_M | ~10 GB |
| Maximale Qualität (32 GB) | Llama 3.3 70B | Q4_K_M | ~40 GB |
Wer nutzt LM Studio 2026?
Anwalt, Notar, Jurist
Verträge analysieren, Schriftsätze verfassen, eine Dokumentenbank abfragen – ohne Kundendaten einem externen Server auszusetzen. LM Studio ist in 10 Minuten eingerichtet, ohne IT-Aufwand.
Forscher, Akademiker
Vergleich mehrerer Modelle mit denselben Prompts, Hypothesen testen, wissenschaftliche Literatur zusammenfassen. Die Side-by-Side-Vergleichsfunktion ist genau dafür konzipiert.
Autor, Journalist, Redakteur
Schreibhilfe, Brainstorming, Umformulierung – mit einem Tool, das wie eine echte Anwendung aussieht und nicht wie ein Entwickler-Tool. Ihre Entwürfe bleiben auf Ihrem Rechner.
Gesundheitsfachkraft
Assistierte Berichte, Suche in medizinischer Dokumentation – ohne dass Patientendaten einen externen Server berühren. DSGVO-konform durch die Architektur.
Manager, Berater, Führungskraft
KI-Assistent für E-Mails, Besprechungen, strategische Präsentationen. Verbinden Sie LM Studio über die lokale API mit Obsidian, Cursor oder Ihrer bevorzugten App – ohne ChatGPT-Abonnement.
Student, KI-Interessierter
Lokale KI ohne Befehlszeile erkunden. Verschiedene Modelle testen, Funktionsweise verstehen, einen persönlichen Assistenten für das Studium erstellen – ohne Nutzungsgebühren.
Unsere vorkonfigurierten PCs für LM Studio – montiert in Auriol, Provence
Radiance Systems bietet Workstations an, die mit vorinstalliertem LM Studio und den Modellen Ihrer Wahl geliefert werden. Sie starten Ihren PC, öffnen LM Studio, wählen Ihr Modell aus und beginnen zu arbeiten. Keine technische Konfiguration erforderlich.

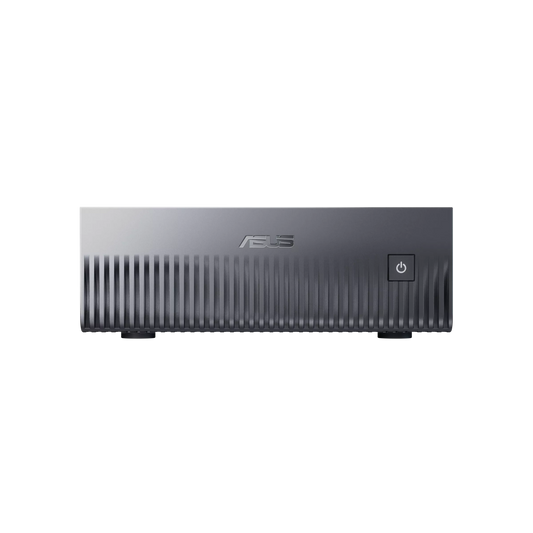
Mini IA Server NVIDIA GB10 — ASUS Ascent GX10
✅ DeepSeek V4 Flash FP16 · Llama 4 Maverick FP16 · Modelle bis zu 200B in GGUF
Das einzige Desktop-Format, das 200B-Modelle laden kann – auf keiner gängigen GPU möglich. 128 GB Unified Memory, leise, 15×15 cm. Ideal für Büros, die maximale Kapazität in einem ultrakompakten Format wünschen.
LM Studio vorinstalliert · Modelle nach Wahl heruntergeladen
Diesen Server konfigurieren →
Radiance PC CoreAI 16 — RTX 5060 Ti 16 GB
✅ Qwen 3.5 14B · Mistral Medium 3.5 · Phi-4 14B · Gemma 4 26B QAT
LM Studio Geschwindigkeit: 50-55 Token/Sekunde
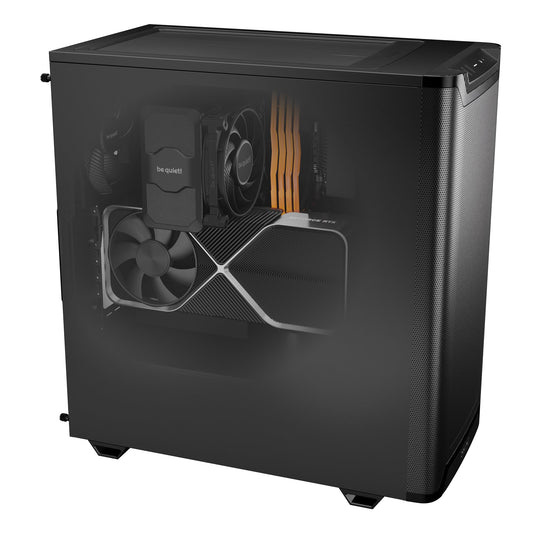
Der Sweet Spot 2026 für LM Studio. 16 GB GDDR7 laden 14B-Modelle vollständig in die GPU – flüssige Antworten, natürliche Konversation. Kompakter und leiser Tower, Windows 11 Pro inklusive. Die ideale Konfiguration für einen Profi, der die lokale KI entdeckt.
LM Studio + Qwen 3.5 14B + Mistral auf Anfrage vorinstalliert
Diese Station konfigurieren →
Radiance PC CoreAI 32 — RTX 5070 Ti 16 GB
✅ Gemma 4 26B · Qwen 3.5 32B · Flüssiger Side-by-Side-Vergleich · Kontext 64K
LM Studio Geschwindigkeit: 30-45 Token/Sekunde
Die Station für Benutzer, die die Vergleichsfunktion von LM Studio voll ausnutzen. 32 GB DDR5 halten 2-3 Modelle im RAM für sofortiges Umschalten – ideal für Forscher, die testen und vergleichen.
Ideal für Forscher · Multi-Modell · Intensive Nutzung
Diese Station konfigurieren →
⭐ Radiance PC CoreAI 64 — RTX 5090 32 GB
✅ Llama 3.3 70B Q4 · Qwen 3.5 72B Q4 · DeepSeek V4 Flash
LM Studio Geschwindigkeit: 15-25 Token/s auf 70B — Qualität nahe GPT-4o
Der beste Consumer-PC für LM Studio im Jahr 2026. 32 GB GDDR7 für 70B-Modelle vollständig auf der GPU – die GPT-4o am nächsten kommende Qualität lokal verfügbar. Die Rekordbandbreite (1.792 GB/s) gleicht die Anwendungsebene von LM Studio aus.
Llama 3.3 70B + Qwen 3.5 72B auf Anfrage vorinstalliert
Diese Station konfigurieren →
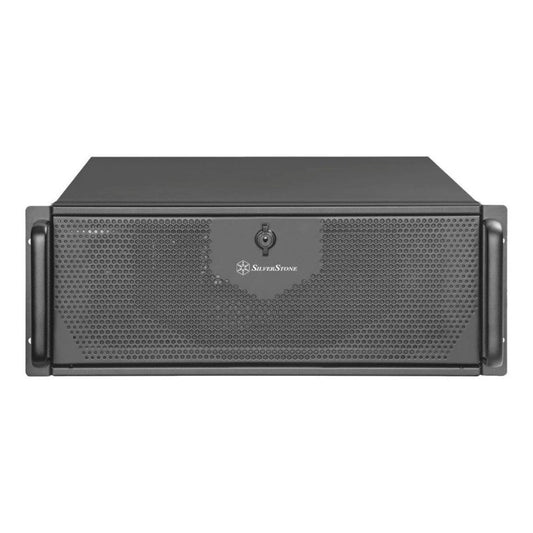
Radiance CoreAI Rack — 2× RTX 5090 (64 GB VRAM)
✅ LM Studio Developer Mode Headless · Geteilte Multi-Team-API · Llama 3.3 70B FP16
Für Büros und Teams von 5 bis 20 Personen. LM Studio im Developer Mode 2026.4 als Headless-Server gestartet: Jeder Mitarbeiter greift über die lokale API von seinem eigenen PC aus zu, ohne etwas installieren zu müssen. Der Server zentralisiert die großen Modelle.
LM Studio Server-Modus · Team-API · Rack 4U
Dieses Rack konfigurieren →
CoreAI 128 Rack — 2× RTX 6000 PRO Blackwell (192 GB ECC)
✅ DeepSeek V4 Pro · Kimi K2.6 · Alle GGUF-Modelle in nativer Präzision · Produktion 24/7
Für Organisationen, die die leistungsstärksten Modelle lokal, in nativer Präzision, ohne Quantisierung wünschen. 192 GB VRAM ECC, maximale Zuverlässigkeit für 24/7-Betrieb ohne Unterbrechung.
Installation vor Ort · Dedizierter Support · Rack 4U
Dieses Rack konfigurieren →Häufig gestellte Fragen — PC für LM Studio
Ist LM Studio wirklich ohne technische Kenntnisse nutzbar?
Ja – das ist sein Hauptvorteil. Sie laden LM Studio von lmstudio.ai herunter, installieren es wie jede andere Windows-Anwendung, suchen ein Modell im integrierten Browser (automatisch nach VRAM gefiltert), klicken auf Herunterladen, dann auf Laden und können dann chatten. Keine Befehlszeile, keine Konfigurationsdateien, keine manuell zu installierenden Treiber.
Was ist der Unterschied zwischen LM Studio und ChatGPT?
ChatGPT läuft auf den Servern von OpenAI – Ihre Gespräche werden ins Internet gesendet. LM Studio führt das Modell direkt auf Ihrem PC aus – keine Daten verlassen Ihre Maschine. LM Studio ist auch vollständig kostenlos nutzbar. Im Jahr 2026 konkurrieren die lokal verfügbaren Modelle (Qwen 3.5, Mistral, Llama 4) in fast allen gängigen professionellen Aufgaben mit GPT-4o.
Welcher PC ist mindestens für LM Studio erforderlich?
Wenn Sie bereits einen neueren PC mit einer NVIDIA 12 GB+ GPU haben, funktioniert LM Studio. Für einen neuen dedizierten PC ist der CoreAI 16 RTX 5060 Ti 16 GB (~1.700 €) der Sweet Spot – er führt Qwen 3.5 14B mit 50-55 Token/s aus, was für den komfortablen und flüssigen täglichen professionellen Einsatz ausreicht.
Kann LM Studio mit anderen Anwendungen verbunden werden?
Ja. Durch Aktivieren des lokalen Servers in LM Studio (ein Knopf in der Benutzeroberfläche) stellen Sie eine OpenAI-kompatible API unter localhost:1234 bereit. Sie können dann verbinden: Cursor (KI-Code-Editor), Continue.dev (VS Code-Erweiterung), Obsidian AI (intelligente Notizen), Open WebUI (erweiterte Chat-Oberfläche) oder jede andere App, die eine benutzerdefinierte OpenAI-API unterstützt – ohne eine einzige Codezeile ändern zu müssen.
Was ist der Unterschied zwischen Q4_K_M, Q5_K_M und Q8?
Q4_K_M ist der Standard 2026: ~10 GB für ein 14B-Modell, ausgezeichnete Qualität, kaum wahrnehmbarer Verlust. Q5_K_M bietet eine leicht bessere Qualität (~12 GB), bevorzugt, wenn Ihr VRAM dies zulässt. Q8_0 ist nahezu identisch mit nativer Präzision, aber doppelt so groß – nur nützlich bei 24 GB+ VRAM. In LM Studio wird jedes Modell in mehreren Formaten mit einer klaren GPU-Kompatibilitätsanzeige entsprechend Ihrer Konfiguration angeboten.
Funktioniert LM Studio auf Mac oder Linux?
Ja. LM Studio ist für Windows, macOS (Apple Silicon wird über Metal sehr gut unterstützt) und Linux verfügbar. Auf Mac M4 Pro 24 GB ist die Leistung für 14B-26B-Modelle gut. Unter Windows und Linux mit NVIDIA-GPU ist die Leistung am besten – CUDA bietet den besten Durchsatz für GGUF-Modelle.
Verbraucht LM Studio viel Strom?
Im Ruhezustand: 30-50 W. Bei aktiver Konversation mit einem 14B-Modell mit RTX 5060 Ti: 200-250 W. Bei einem 70B-Modell mit RTX 5090: 550-600 W in der Spitze. Bei 2-3 Stunden täglicher Nutzung erhöht sich Ihre Stromrechnung um 10-20 €/Monat – deutlich günstiger als ein ChatGPT Pro-Abonnement und ohne Datenübertragung ins Internet.
Werden unsere PCs mit vorinstalliertem LM Studio geliefert?
Ja, auf Anfrage. Wir können Ihre Workstation mit installiertem LM Studio, den von Ihnen gewählten Modellen (Qwen 3.5 14B, Mistral Medium 3.5 oder andere je nach Ihrem Bedarf) und auf Ihr Profil abgestimmten Einstellungen liefern. Sie schalten Ihren PC ein und chatten in weniger als 2 Minuten mit Ihrer KI.