Lokale KI-PCs 2026: Welche Hardware wird benötigt, um ein LLM lokal auszuführen?
Im Jahr 2026 ist das lokale Ausführen einer künstlichen Intelligenz nicht mehr nur Rechenzentren oder Ingenieuren vorbehalten. Die Qualität von Open-Source-Modellen ist explosionsartig gestiegen – Llama 4, Qwen 3.5, DeepSeek V4, Gemma 4, Mistral Large 3 konkurrieren nun mit den besten proprietären Modellen – und Consumer-Hardware ermöglicht es, diese voll auszunutzen. Dieser Leitfaden erklärt Ihnen, wie Sie Ihren lokalen KI-PC je nach Nutzung und Budget auswählen.
Warum sich lokale KI 2026 durchsetzt?
1. Datenschutz und DSGVO – eine Verpflichtung für reglementierte Berufe
Eine lokale KI-Workstation löst dieses Problem konzeptbedingt. Die Daten verlassen niemals Ihr Netzwerk. DSGVO-Konformität nativ garantiert, Berufsgeheimnis gewahrt, keine Übertragung außerhalb der EU.
2. Keine wiederkehrenden Kosten
Ein ChatGPT Pro-Abonnement kostet 20 €/Monat/Nutzer – 240 €/Jahr. Für ein Team von 5 Personen sind das 1.200 €/Jahr reine Ausgaben, plus Ihre Daten auf Servern Dritter. Eine lokale KI-Workstation amortisiert sich in 12 bis 24 Monaten und produziert dann jahrelang ohne zusätzliche Kosten.
3. Open-Source-Modelle haben 2026 das Frontier-Niveau erreicht
Die besten Open-Source-LLM-Modelle für den lokalen Einsatz – Mai 2026
| Modell | Größe / Architektur | VRAM (Q4) | Stärken | Ideal für |
|---|---|---|---|---|
| Llama 4 Scout 17B | 17B MoE · Meta | ~10-12 GB | Bestes Qualität/VRAM-Verhältnis 2026, 10M Kontext | Allgemeine Nutzung, 12 GB VRAM |
| Gemma 4 26B QAT | 26B dense · Google | ~14 GB | 85 Token/s auf Consumer-GPU, 256K Kontext, multimodal | Geschwindigkeit + Qualität, lange Zusammenfassungen |
| Qwen 3.5 14B / 32B ⭐ | MoE · Alibaba | ~10 GB (14B) / ~20 GB (32B) | Mehrsprachigkeit, multimodal, 8,6× höherer Durchsatz vs. Qwen3 | Deutsch, mehrsprachig, vielseitig |
| DeepSeek V4 Flash | 284B gesamt / 13B aktiv | ~10-12 GB | Fortgeschrittenes Reasoning, Code, Agentic, MIT | Buchhaltung, Code, Analyse |
| Mistral Medium 3.5 | MoE · Mistral AI | ~16 GB | 77,6% SWE-Bench, EU-freundlich, exzellent in Deutsch | Recht, Redaktion, europäische Kanzleien |
| DeepSeek R2 8B | 8B dense · MIT | ~5 GB | Bestes Mathematik/Logik-Reasoning in 8B, leichtgewichtig | Bescheidene Maschinen, schnelle Analyse |
| Kimi K2.6 | 1T MoE / variable Aktive | Multi-GPU | #1 Open-Source-Coding (Quality Index 53,9) | Entwicklerteams, KI-Server |
| DeepSeek V4 Pro | 1,6T gesamt / 49B aktiv | Multi-GPU | 90,1% GPQA Diamond, 1M Kontext, GPT-5-Mini-Niveau | Enterprise KI-Server |
Quellen: CoderSera (Mai 2026), BentoML (Mai 2026), PromptQuorum (Mai 2026), WhatLLM.org (April 2026). Aktualisiert am 13. Mai 2026.
So wählen Sie Ihren lokalen KI-PC: VRAM ist entscheidend
Das wichtigste Kriterium für lokale LLM-Inferenz ist der GPU-Speicher (VRAM). Die Inferenz wird durch die Speicherbandbreite begrenzt – die GPU lädt die Modellgewichte kontinuierlich aus dem VRAM. Mehr VRAM = größere Modelle = bessere Antworten.
| Verfügbarer VRAM | Kompatible Modelle (Q4) | Beispiele Mai 2026 | Geschwindigkeit ca. |
|---|---|---|---|
| 5-8 GB | Bis zu 9B | DeepSeek R2 8B, Qwen3 8B, Gemma 3 4B | 50–90 Token/s |
| 12 GB | Bis zu 17B MoE | Llama 4 Scout 17B, Gemma 3 12B | 30–50 Token/s |
| 16 GB ⭐ Sweet Spot | Bis zu 14B dense / 17B MoE | Qwen 3.5 14B, Mistral Medium 3.5, Llama 4 Scout | 40–70 Token/s |
| 24 GB | Bis zu 27-32B | Qwen 3.5 32B, Gemma 4 26B | 25–45 Token/s |
| 32 GB (RTX 5090) | Bis zu 70B in Q4 | Llama 4 Maverick Q4, Qwen 3.5 72B Q4 | 15–30 Token/s |
| 128 GB Unified (GB10) | Bis zu 200B+ in Q4 | DeepSeek V4 Flash FP16, Llama 4 Maverick FP16 | 20–40 Token/s |
| 64–192 GB (Multi-GPU) | 70B FP16 bis 500B+ MoE | DeepSeek V4 Pro, Kimi K2.6, GLM-5.1 | Variabel |
Unsere lokalen KI-Workstations – konfiguriert, getestet, einsatzbereit geliefert
Radiance Systems entwickelt lokale KI-Workstations für Fachleute, die ihre Daten keinem externen Server anvertrauen können. Jede Maschine wird von Hand in Auriol (13390), Provence, montiert und europaweit geliefert.

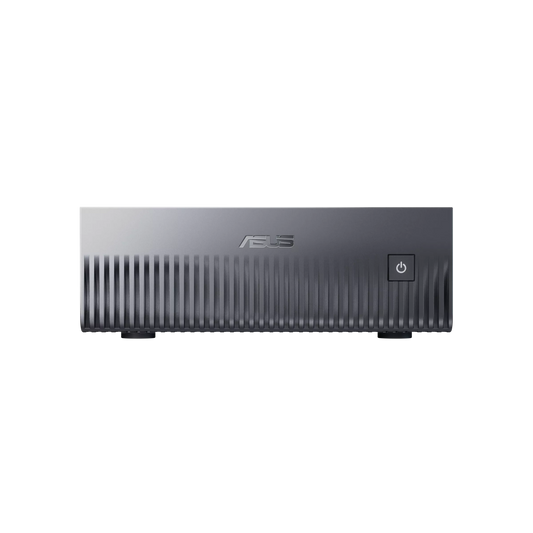
Mini KI-Server NVIDIA GB10 — ASUS Ascent GX10
✅ Llama 4 Maverick FP16 · DeepSeek V4 Flash FP16 · Bis zu 200B Parameter
128 GB Unified Memory ermöglichen das Laden von Modellen, die selbst eine RTX 5090 (32 GB) nicht halten kann. Formfaktor 15×15 cm, leise, benötigt eine Standardsteckdose. CPU+GPU-Architektur auf einem einzigen Chip mit NVLink-C2C bei 900 GB/s.
Einsatzbereit geliefert · Ollama auf Wunsch vorinstallierbar
Diesen Server konfigurieren →
Radiance PC CoreAI 16 — RTX 5060 Ti 16 GB
✅ Qwen 3.5 14B · Mistral Medium 3.5 · Llama 4 Scout 17B · 40-70 Token/s
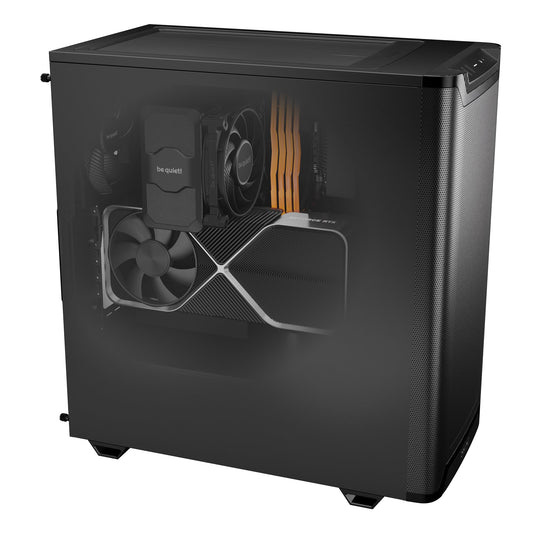
Der Sweet Spot 2026 für professionelle lokale KI. 16 GB GDDR7 für 14-17B Modelle vollständig auf der GPU. AM5 DDR5 Plattform, kompaktes und leises Gehäuse. Idealer Einstiegspunkt für eine Einzelkanzlei.
Vollständig konfigurierbar · Gehäuse, RAM, SSD nach Wahl
Diese Workstation konfigurieren →
Radiance PC CoreAI 32 — RTX 5070 Ti 16 GB
✅ Gemma 4 26B · Qwen 3.5 32B · DeepSeek V4 Flash · 25-45 Token/s
Die vielseitige Workstation für anspruchsvolle Freiberufler. Deutlich höhere Speicherbandbreite für 26-32B Modelle. Ryzen 9 9900X für gemischte CPU-Lasten (RAG, Dokumentenverarbeitung, n8n).
Vollständig konfigurierbar · Kühlung, GPU, Speicher nach Wahl
Diese Workstation konfigurieren →
Radiance PC CoreAI 64 — RTX 5090 32 GB
✅ Llama 4 Maverick Q4 · Qwen 3.5 72B Q4 · DeepSeek V4 Flash Q4 · 15-30 Token/s
Die beste Consumer-GPU für LLM-Inferenz im Jahr 2026. 1.792 GB/s Bandbreite, Rekord auf dem Consumer-Markt. 70B Modelle in Q4 vollständig auf der GPU. Leichtes Fine-Tuning möglich. Ryzen 9 9950X3D für intensive RAG-Pipelines.
Vollständig konfigurierbar · Fine-Tuning möglich
Diese Workstation konfigurieren →
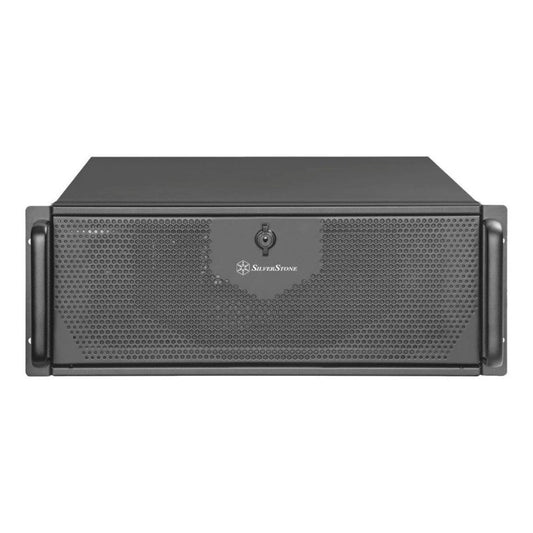
Radiance CoreAI Rack — 2× RTX 5090 (64 GB VRAM)
✅ DeepSeek V4 Flash FP16 · Llama 4 Maverick FP16 · Simultane Multi-GPU-Inferenz
64 GB Gesamt-VRAM für Teams von 5 bis 20 Benutzern, die einen internen KI-Server teilen. Simultane Inferenz auf zwei unabhängigen GPUs. Ideal für Kanzleien mit mehreren Mitarbeitern.
Maßgeschneidert · Rack 4U · Angebot auf Anfrage
Dieses Rack konfigurieren →
CoreAI 128 Rack — 2× RTX 6000 PRO Blackwell (192 GB ECC)
✅ Kimi K2.6 · DeepSeek V4 Pro Q4 · Fine-Tuning 70B+ · GPU-Virtualisierung
Professionelle GPUs mit ECC-Speicher für kontinuierliche Produktion. 192 GB ECC VRAM ermöglichen das Laden der größten Open-Source-Modelle – Kimi K2.6, DeepSeek V4 Pro – in nativer Präzision oder hoher Qualität. Maximale Zuverlässigkeit für kritische Umgebungen.
Maßgeschneidert · Rack 4U · Installation vor Ort möglich
Dieses Rack konfigurieren →
Radiance PC Pro AI Ultra Threadripper
✅ Fine-Tuning · Verteiltes Training · Massive RAG-Pipelines · HPC · Simulation
Die ultimative Workstation für anspruchsvolle Produktionsumgebungen. Threadripper PRO sTR5-Plattform, erweiterbar auf bis zu 96 Kerne und 2 TB ECC RDIMM RAM. Für gemischte Workloads: KI, 3D-Rendering, Simulation, HPC. Die skalierbarste Lösung im Katalog.
Maßgeschneidert · Individuelles Angebot · Installation vor Ort
Angebot anfordern →Welcher lokale KI-PC passt zu Ihrem Profil?
| Profil | Empfohlene Konfiguration | Ziel-LLM-Modelle (Mai 2026) | Budget |
|---|---|---|---|
| Einzelner Freiberufler | CoreAI 16 RTX 5060 Ti 16 GB | Qwen 3.5 14B, Mistral Medium 3.5, Llama 4 Scout | ~1.700€ |
| Kompakte Einzelkanzlei ⭐ | ASUS Ascent GX10 (GB10) | Bis zu 200B · DeepSeek V4 Flash FP16 | ~4.000€ |
| Gemischte Nutzung KI + intensive Büroarbeit | CoreAI 32 RTX 5070 Ti | Gemma 4 26B, Qwen 3.5 32B | ~2.400€ |
| 70B-Modelle, leichtes Fine-Tuning | CoreAI 64 RTX 5090 | Llama 4 Maverick Q4, DeepSeek V4 Flash Q4 | ~6.000€ |
| Team 5-20 Personen, interner KI-Server | Rack 2× RTX 5090 | DeepSeek V4 Flash FP16, gleichzeitige Inferenz | ~11.000€ |
| Kontinuierliche Produktion, Fine-Tuning 70B+ | Rack 2× RTX 6000 ECC | Kimi K2.6, DeepSeek V4 Pro | ~28.000€ |
| KI-Infrastruktur HPC / F&E | Pro AI Ultra Threadripper | Alle Modelle, verteiltes Training | ~20.000€+ |
Lokale KI für Ihr Geschäft
Anwälte & Notare
Analysieren Sie Akten und Verträge, fassen Sie diese in natürlicher Sprache zusammen, identifizieren Sie Risikoklauseln – ohne Ihre Kunden bloßzustellen. RAG auf Ihrer internen Dokumentenbasis.
Ärzte & Kliniken
Diktierte Berichte, analysierte Patientenakten, abgefragte medizinische Datenbanken – ohne dass ein einziges Byte Ihr Netzwerk verlässt.
Wirtschaftsprüfer & Auditoren
Analysieren Sie Bilanzen, erkennen Sie Anomalien, erstellen Sie Berichte – ohne jemals die vertraulichen Zahlen Ihrer Kunden hochzuladen.
Ingenieurbüros & F&E
Nutzen Sie KI für Ihre Forschung und Simulationen, ohne Patente, Formeln oder Projektdaten Dritten zugänglich zu machen.
KMU & Geschäftsleitungen
KI-Assistent, der mit Ihren internen Dokumenten, Prozessen und Ihrem CRM verbunden ist – für alle Ihre Teams, in Ihrem Netzwerk, ohne externen Zugriff.
Entwickler & Tech-Teams
Code-Assistenz (Kimi K2.6, Qwen 3.5 Coder), Debugging, Refactoring – vollständig lokal mit Ihrer proprietären Codebasis.
Häufig gestellte Fragen – Lokaler KI-PC 2026
Welches ist das beste lokale LLM-Modell im Mai 2026?
Das hängt vom Anwendungsfall ab. Llama 4 Scout 17B bietet das beste Verhältnis von Qualität zu VRAM (12 GB) für den allgemeinen Gebrauch. Qwen 3.5 14B glänzt in Mehrsprachigkeit und Französisch. DeepSeek V4 Flash ist am besten für Argumentation und Code. Gemma 4 26B QAT ist das schnellste (85 Tok/s auf Consumer-GPUs). Für Server mit mehr VRAM erreichen DeepSeek V4 Pro und Kimi K2.6 das Niveau der besten proprietären Modelle.
Kann ein lokales LLM im Jahr 2026 mit ChatGPT mithalten?
Bei fast allen täglichen beruflichen Aufgaben ja. DeepSeek V4 Pro erreicht 90,1 % auf GPQA Diamond – auf dem Niveau von GPT-5-mini. Mistral Medium 3.5 erreicht 77,6 % auf SWE-Bench Verified für Code. Die verbleibende Lücke besteht bei sehr komplexen Argumentationsaufgaben und fortschrittlicher Multimodalität. Für juristische, medizinische und buchhalterische Anwendungen ist ein gutes lokales Modell mehr als ausreichend.
Benötigt man technische Kenntnisse, um ein lokales LLM zu verwenden?
Nein. Unsere Workstations werden auf Anfrage mit vorinstalliertem Ollama und Open WebUI geliefert – einer intuitiven Web-Oberfläche ähnlich ChatGPT, die vollständig lokal über einen Browser läuft. Für den täglichen Gebrauch ist keine Kommandozeile erforderlich.
Kann man seine Dokumente mit einem lokalen LLM verbinden (RAG)?
Ja. Open WebUI integriert nativ das Dokumenten-RAG – laden Sie Ihre PDFs, Word- oder Excel-Dateien hoch und fragen Sie diese direkt in natürlicher Sprache ab. Für fortgeschrittenere Pipelines kann n8n vollständige Workflows zwischen Ihren Dateien, Ihrem lokalen LLM und Ihren Geschäftsanwendungen orchestrieren.
Liefern Sie außerhalb Frankreichs?
Ja, Radiance Systems liefert in die gesamte Europäische Union. Die Installation vor Ort ist in Frankreich und den angrenzenden Ländern möglich. Ferninstallation ist auch über SSH oder TeamViewer verfügbar.