Eine oder zwei Grafikkarten für lokale KI? Multi-GPU-Leitfaden 2026
Zwei Grafikkarten.
Nicht doppelt so schnell.
Multi-GPU dient anderen Zwecken. Hier erfahren Sie, wozu und wie viele Karten Sie je nach Anwendungsfall konfigurieren sollten.
Das ist die Frage, die sich alle stellen, die in eine höhere Leistungsklasse aufsteigen: Warum nicht zwei Grafikkarten einbauen, anstatt eine teurere zu kaufen? Die Intuition dahinter ist einfach. Sie ist jedoch weitgehend falsch, und zwar aus einem mechanischen Grund, den man vor dem Kauf verstehen sollte.
Der Mythos von den zwei Karten
Warum Ihr Chat nicht schneller wird
Bei der Textgenerierung produziert ein Modell ein Token nach dem anderen. Für jedes Token liest es die vollständigen Gewichte aus dem Videospeicher. Die Geschwindigkeit hängt daher von der Bandbreite einer einzelnen Karte ab, nicht von deren Anzahl.
Wenn ein Modell auf zwei Karten verteilt ist, werden die Schichten nacheinander verarbeitet: Die erste Karte berechnet ihren Teil, überträgt das Ergebnis, die zweite übernimmt. Zu jedem Zeitpunkt arbeitet nur eine Karte. Die andere wartet.
Das Ergebnis: Ein auf zwei Karten verteiltes Modell läuft in etwa mit der Geschwindigkeit einer einzelnen Karte, zuzüglich eines leichten Kommunikationsaufwands. Das ist kein Konfigurationsfehler. Das ist die Natur der Berechnung.
Vereinfachtes Schema der Schichtverteilung. Jede Karte verarbeitet abwechselnd die Hälfte des Modells. Die Anzahl der pro Sekunde generierten Token bleibt vergleichbar mit der einer einzelnen Karte.
Was zwei Karten wirklich leisten
Was Multi-GPU bringt
- Addierter Speicher. Zwei 32-GB-Karten ermöglichen das Laden eines 64-GB-Modells. Das ist der Hauptvorteil und oft der einzige, der zählt.
- Multiplizierter Durchsatz bei geteilter Nutzung. Mehrere Nutzer oder mehrere Agenten parallel: Jede Karte verarbeitet ihre eigenen Anfragen. Hier ist der Gewinn real.
- Längerer Kontext. Der freigesetzte VRAM dient dem Kontext-Cache, was lange Kontextfenster bei großen Modellen ermöglicht.
- Unterschiedliche Aufgaben parallel. Ein Sprachmodell auf der einen Karte, Bildgenerierung auf der anderen.
Was Multi-GPU nicht leistet
- Beschleunigung einer einzelnen Konversation. Der Durchsatz in Token pro Sekunde folgt der Bandbreite einer Karte.
- Aufteilung der Bildgenerierung. Tools wie ComfyUI und Videomodelle verteilen sich nicht nativ auf mehrere Karten.
- Ersetzen einer Profi-Karte für das Training. Ohne NVLink bremst die Gradientensynchronisation über PCIe stark.
- Auskommen mit einem Standard-Mainboard. Consumer-Plattformen teilen ihre PCIe-Lanes zwischen den beiden Karten auf.
Wie viele Karten konfigurieren? Der Entscheidungsbaum
Wie weit kann man gehen? Die Konfigurationsstufen
Die Anzahl der Karten, die Sie installieren können, hängt von der Plattform und vor allem von deren PCIe-Lanes ab. Hier zeigt sich der wahre Unterschied zwischen einer Consumer-Basis und einer professionellen Workstation.
| Konfiguration | Gesamt-VRAM | Plattform | Zielanwendung |
|---|---|---|---|
| 1 × RTX 5090 | 32 GB | Consumer-Tower | Individuelle Nutzung, Modelle bis 70B in 4-Bit |
| 2 × RTX 5090 | 64 GB | 4U-Rack, 2000 W | Team, lange Kontexte bei großen Modellen |
| 1 × RTX 6000 Blackwell | 96 GB ECC | Workstation oder Rack | Große Modelle solo, Fine-Tuning, ECC |
| 2 × RTX 6000 Blackwell | 192 GB ECC | 4U-Rack, Threadripper PRO | Produktion, viele Nutzer |
| 3 × RTX 6000 Blackwell | 288 GB ECC | Threadripper PRO, volle PCIe-Anbindung | Forschung, Training, sehr große Modelle |
| 4 × RTX PRO 6000 Blackwell | 384 GB ECC | Threadripper PRO, mehr Karten auf Anfrage | Sehr große Modelle, mehrere Modelle parallel |
Welche Karte wählen, bevor die Anzahl feststeht
Die Wahl des Kartenmodells steht vor der Quantität. Hier sehen Sie den Vergleich der beiden Referenzen in Einzel- und Multi-GPU-Konfigurationen. Beide Referenzen sind in unserer KI-Reihe sowohl in Einzel- als auch in Multi-GPU-Versionen erhältlich.
| Kriterium | RTX 5090 (32 GB) | 2 × RTX 5090 (64 GB) | RTX 6000 Blackwell (96 GB) |
|---|---|---|---|
| Gesamt-VRAM | 32 GB | 64 GB | 96 GB |
| 70B Modell in 4-Bit | Passt, kurzer Kontext | Komfortabel | Großer Spielraum |
| Geschwindigkeit, Solo | Maximal | Vergleichbar mit einer Karte | Hoch, kein Flaschenhals |
| Mehrere Nutzer | Begrenzt | Durchsatz multipliziert | Gut, geteilter Speicher |
| Bild- und Videogen. | Exzellent | Eine Karte gleichzeitig | Exzellent |
| Fine-tuning | LoRA bis ca. 13B | Durch PCIe gebremst | QLoRA bei 70B |
| ECC-Speicher | Nein | Nein | Ja |
| Erweiterbar bis | 3 Karten im Konfig., 4+ auf Anfrage | 3 Karten im Konfig., 4+ auf Anfrage | 3 Karten im Konfig. (Threadripper), 4+ auf Anfrage |
| GPU-Verbrauch | 575 W | 1150 W | 600 W |
Die versteckten Kosten einer zweiten Karte
Der Preis der Karte ist nur der Anfang. Eine ernsthafte Bi-GPU-Konfiguration zieht vier Punkte nach sich, die in Komponentenlisten oft vergessen werden.
PCIe-Lanes
Consumer-Prozessoren bieten nur 16 bis 24 PCIe-Lanes. Bei zwei Karten teilen diese sich auf einem Standard-Mainboard in x8 und x8 auf. Deshalb wechseln wir bei Konfigurationen mit zwei Karten in das Rack-Format, und deshalb erfordern drei Karten die Threadripper-PRO-Plattform, da nur diese genug Lanes besitzt, um alle Karten voll anzubinden.
Stromversorgung
Eine RTX 5090 verbraucht 575 W. Bei zwei Karten benötigen Sie ein Netzteil mit mindestens 1500 W, vorzugsweise 2000 W in der Platinum-Klasse. Darüber hinaus, bei Systemen mit drei Profi-Karten, sind die elektrische und thermische Dimensionierung fester Bestandteil der Beratung, die wir mit Ihnen durchführen.
Kühlung und Gehäuse
Zwei Karten unter Last erzeugen doppelt so viel Hitze, auf engem Raum, wo sie sich gegenseitig beeinflussen. Sie benötigen ein Gehäuse mit einem durchdachten Luftstrom und oft ein Rack-Format, das die Karten physisch trennt.
Systemspeicher
Das Modell durchläuft den RAM, bevor es in den VRAM geladen wird. Die Faustregel: mindestens doppelt so viel Arbeitsspeicher wie der gesamte VRAM. Rechnen Sie bei 64 GB VRAM also mit 128 GB RAM.
Wie Software das Modell verteilt
Es existieren zwei Ansätze, die nicht gleichwertig sind.
Schichtweise Verteilung. Dies erledigen Ollama und llama.cpp automatisch. Jede Karte erhält einen Teil des Modells und verarbeitet ihn nacheinander. Wenig Kommunikation zwischen den Karten, daher PCIe-tolerant, aber kein Geschwindigkeitsgewinn im Solo-Betrieb. Dies ist der Standardmodus und die richtige Wahl für Consumer-Hardware.
Tensor-Parallelismus. Dies wird von vLLM angeboten. Jeder Vorgang wird zwischen den Karten aufgeteilt, die gleichzeitig arbeiten. Ein echter Geschwindigkeitsvorteil ist möglich, erfordert aber viel Bandbreite zwischen den Karten. Ohne NVLink bleibt der Vorteil bescheiden und hängt stark von den verfügbaren PCIe-Lanes ab.
Unsere Plattformen, konfigurierbar in der Anzahl der Karten
Jede Maschine wird in Auriol (13390) von Hand gefertigt und ist vollständig konfigurierbar, inklusive der Anzahl der Grafikkarten. Passen Sie die Konfiguration im Online-Konfigurator an oder beschreiben Sie uns Ihren Anwendungsfall für ein maßgeschneidertes Angebot an contact@radiancesystems.eu.
Workstation, eine Karte
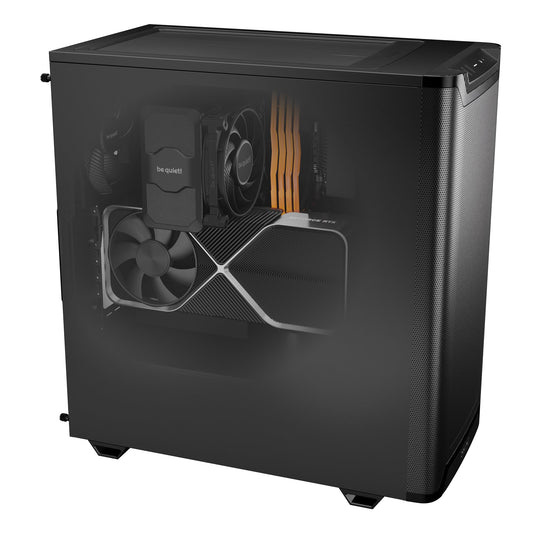
 CoreIA 64 : RTX 5090 32 GBDie Standardwahl für individuelle Nutzung. Grafikkarte konfigurierbar nach Ihrem Bedarf.
8 642 €
Rack, zwei Karten
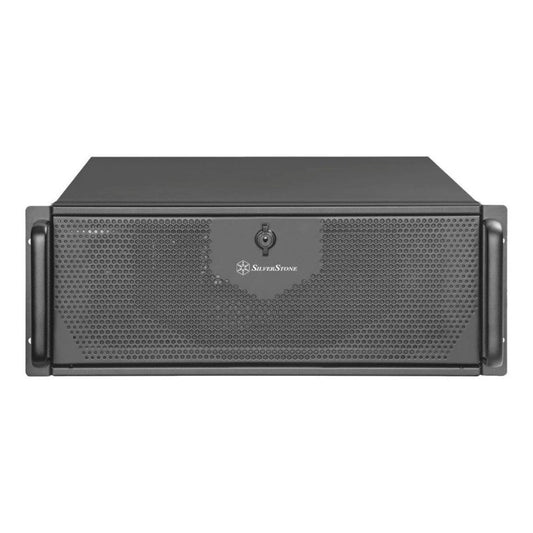
 CoreIA Rack: 2 × RTX 5090, 64 GB4U-Rack, 128 GB RAM, 2000 W. Geteilter Durchsatz und langer Kontext.
17.887 €
CoreIA 128 Rack: 2 × RTX 6000, 192 GB ECC70B-Modell in nativer Präzision, Dutzende Benutzer, Training.
42.452 €
Threadripper PRO, von einer bis vier Karten, oder mehr auf Anfrage
Pro IA Ultra: bis zu 4 × RTX PRO 6000 Blackwell96 bis 288 GB ECC-VRAM im Konfigurator (1 bis 3 Karten), 4 Karten oder mehr auf Angebot. RAM bis 2 TB erweiterbar.
26.890 €
Die Alternative ohne Multi-GPU
 Mini-Server GB10: 128 GB einheitlichEin einzelner Chip, ein einheitlicher 128-GB-Speicher, 240 W. Kein Karten-Bus-Management nötig.
6.299 €
Kurz gefasst
Machen zwei Grafikkarten lokale KI schneller?
Nicht für einen einzelnen Benutzer. Die Generierungsgeschwindigkeit richtet sich nach der Bandbreite einer Karte, und die Karten arbeiten abwechselnd. Der echte Gewinn liegt woanders: mehr Speicher und ein vervielfachter Durchsatz, wenn mehrere Personen oder Agenten gleichzeitig auf den Server zugreifen.
Unterstützen RTX 5090 NVLink?
Nein. NVLink ist bei Consumer-Karten seit der RTX 3090 verschwunden. Zwei RTX 5090 kommunizieren über PCIe, was für die Inferenz geeignet ist, aber das Training verlangsamt.
Sind zwei RTX 5090 oder eine RTX 6000 Blackwell besser?
Für die Kapazität im Alleinbetrieb die RTX 6000: 96 GB auf einer einzigen Karte, ohne Datenaustausch zwischen Karten oder Plattformbeschränkungen, mit ECC. Für geteilten Durchsatz unter mehreren Benutzern haben zwei 5090 Vorteile.
Wie viele Karten können maximal installiert werden?
Das hängt von der Plattform ab. Ein Standard-Tower unterstützt zwei Karten mit geteilten PCIe-Lanes. Unsere auf Threadripper PRO basierende Workstation Pro IA Ultra unterstützt bis zu vier RTX PRO 6000 Blackwell oder mehr, was 384 GB ECC-VRAM bei vier Karten bedeutet: Bis zu drei Karten können direkt im Konfigurator gewählt werden, vier oder mehr auf Anfrage.
Ist die Anzahl der Karten bei der Bestellung festgelegt?
Nein. Alle unsere Geräte sind konfigurierbar, auch in Bezug auf die Anzahl der Grafikkarten. Sie wählen die Konfiguration online oder per Angebot und können mit einer Karte starten und später weitere hinzufügen, sofern die Plattform dies zulässt.
Kann man zwei Karten in einen Standard-PC einbauen?
Physikalisch manchmal möglich, aber die PCIe-Lanes werden dann mit x8/x8 geteilt, und Stromversorgung, Kühlung sowie Arbeitsspeicher müssen darauf ausgelegt sein. Deshalb werden unsere Konfigurationen mit zwei oder mehr Karten als Rack-Modelle oder auf Threadripper-PRO-Plattformen realisiert.
Profitiert die Bildgenerierung von zwei Karten?
Nicht nativ. ComfyUI und Videomodelle nutzen jeweils eine Karte. Zwei Karten ermöglichen es jedoch, ein Sprachmodell auf der einen und die Bildgenerierung auf der anderen Karte laufen zu lassen.
Die Hinweise in diesem Leitfaden sind Richtwerte, die auf öffentlichen Dokumentationen und Rückmeldungen aus dem Ökosystem basieren. Die tatsächliche Leistung hängt vom Inferenz-Motor, dem Verteilungsmodus, der Plattform und dem verwendeten Modell ab. Kontaktieren Sie uns für eine genaue Dimensionierung.