Quel PC pour SenseNova-Loop-9B ? Notre test sur RTX 5060 Ti face à Gemma 4 12B
Mis à jour : 19 novembre 2026
Quel PC pour SenseNova-Loop-9B ?
Nous l'avons testé sur une RTX 5060 Ti 16 Go, face à Gemma 4 12B.
SenseNova-Loop-9B tient sans problème dans notre plus petit PC IA : moins de 6 Go de mémoire GPU en 4 bits. Mais sur nos tâches réelles, il est trois fois plus lent que Gemma 4 12B sur la même carte, et moins fiable. Tous les chiffres de ce test ont été mesurés sur notre machine le 19 novembre 2026.
SenseTime a publié SenseNova-Loop-9B sur Hugging Face le 17 novembre 2026. Ce modèle de 9 milliards de paramètres revendique le niveau de modèles bien plus gros. Sur le papier, c'est le candidat idéal pour une carte grand public comme la RTX 5060 Ti 16 Go. Nous l'avons installé, mesuré et comparé à Gemma 4 12B, le modèle que nous utilisons tous les jours sur la même carte.
La machine de test
| Carte graphique | NVIDIA GeForce RTX 5060 Ti 16 Go |
| SenseNova-Loop-9B | Fichier officiel en 4 bits (Q4_K_M, 5,8 Go), llama.cpp de SenseTime, sous Ubuntu dans Windows (WSL) |
| Gemma 4 12B | 4 bits (Q4_K_M) dans Ollama, sous Windows |
| Réglages communs | Contexte de 8 192 jetons, réflexion désactivée, une seule requête à la fois |
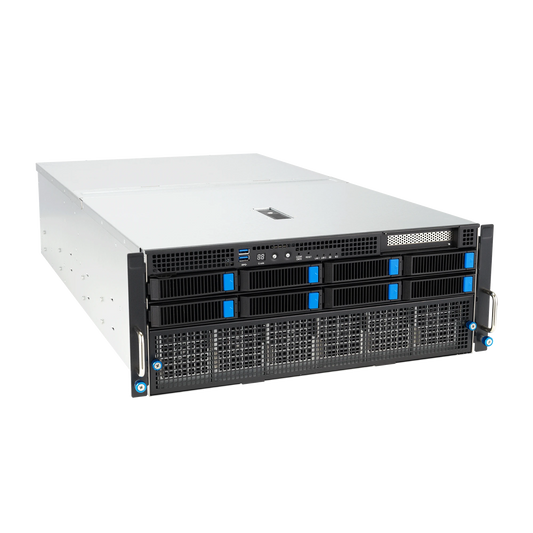
C'est la carte de notre CoreIA RTX 5060 Ti, notre plus petit PC IA.
Un modèle qui passe deux fois par les mêmes couches
SenseNova-Loop-9B a 32 couches, mais 24 d'entre elles sont exécutées deux fois à chaque jeton, avec les mêmes poids. SenseTime parle de « l'équivalent de 14,6 milliards de paramètres » au moment du calcul. La mémoire, elle, ne dépend que des 9,4 milliards de paramètres réellement stockés.
Le revers : peu de mémoire, mais beaucoup de calcul. Dans llama.cpp, un seul jeton généré déclenche environ 52 700 opérations sur la carte. C'est là que se joue la vitesse. Trois couches sur quatre utilisent une attention linéaire : le cache du contexte est minuscule, et c'est une vraie qualité du modèle.
La vitesse, mesurée
| Mesure sur RTX 5060 Ti 16 Go | SenseNova-Loop-9B | Gemma 4 12B |
|---|---|---|
| Génération | 16 jetons/s | 48 jetons/s |
| Lecture d'une invite de 6 500 jetons | 450 à 500 jetons/s | 2 080 jetons/s |
| Premier mot, question courte | 2,4 à 3 s | 0,15 s |
| Premier mot, invite de 6 500 jetons | 15 s | 3,3 s |
| Réponse de 420 jetons sur cette grosse invite | 44 s | 10 s |
| Mémoire de la carte, contexte de 8 192 jetons | 5,9 Go | 8,5 Go |
Mesures de Radiance Systems du 19 novembre 2026, mêmes invites pour les deux modèles, réflexion coupée. Ce sont nos mesures sur une machine et une version de logiciel : un autre réglage peut donner d'autres chiffres.
Pour écarter un effet de WSL, nous avons aussi mesuré Gemma 4 12B avec exactement le même llama.cpp, dans le même WSL : 39 jetons/s en génération, contre 13,5 pour SenseNova (test llama-bench). Gemma y va presque aussi vite que sous Windows avec Ollama. La lenteur vient donc bien de l'architecture en boucle de SenseNova.
La qualité, sur nos tâches réelles
Les scores publiés ne disent pas tout. Nous avons fait passer aux deux modèles les tâches que fait notre IA locale chaque jour, avec exactement le même code :
Un assistant avec outils
67 questions réelles : agenda, e-mails, chiffres, tâches, devis, échanges en plusieurs tours. Un contrôle automatique vérifie que le bon outil est appelé, que l'action est vraiment faite et que rien n'est inventé.
Des e-mails
Résumé en deux ou trois lignes, réponse proposée, réponse rédigée d'après une consigne.
Des traductions
Lignes de devis et blocs de pages web, du français vers l'anglais, l'allemand et le néerlandais.
Pour les e-mails et les traductions, chaque paire de réponses a été notée à l'aveugle de 1 à 5 par un correcteur IA séparé. Les réponses étaient tirées au sort sous les lettres A et B, sans que le correcteur sache laquelle venait de quel modèle.
| Tâche | SenseNova-Loop-9B | Gemma 4 12B |
|---|---|---|
| Assistant avec outils (contrôle automatique) | 52 sur 67 | 67 sur 67 |
| Temps médian d'une réponse de l'assistant | 14,5 s | 2,9 s |
| Banc complet de l'assistant | 33 min | 4 min 20 |
| Préparer un e-mail (résumé et réponse proposée) | 28 à 61 s | 6 à 15 s |
| Traduire 9 lots de devis en trois langues | 11 min | 3 min 30 |
| Traduire 9 blocs de pages web | 6 min 30 | 1 min 50 |
| E-mails, note moyenne (15 tâches) | 3,3 sur 5 | 3,8 sur 5 |
| Traduction de lignes de devis (9 tâches) | 2,4 sur 5 | 3,7 sur 5 |
| Traduction de pages web (9 tâches) | 2,7 sur 5 | 4,1 sur 5 |
| Tâches gagnées à l'aveugle | 6 | 22 (5 égalités) |
Et avec la réflexion activée ?
SenseTime compare son modèle à des modèles bien plus gros, et ces scores sont mesurés en laissant le modèle réfléchir avant de répondre. Nous avons donc refait les mêmes tâches avec la réflexion activée pour les deux modèles : 6 000 jetons de plus pour réfléchir, contexte de 16 384 jetons. La réflexion n'est jamais comptée dans la réponse notée, et la notation à l'aveugle a été refaite par un nouveau correcteur.
| Sans, puis avec réflexion | SenseNova-Loop-9B | Gemma 4 12B |
|---|---|---|
| E-mails, note moyenne (15 tâches) | 3,3 puis 3,4 | 3,8 puis 4,1 |
| Temps médian pour un e-mail | 37 s puis 84 s | 9 s puis 97 s |
| Lignes de devis (9 lots) | 8 lots rendus, note moyenne 2,3 | 5 lots rendus seulement, tous notés 4 |
| Blocs de pages web | 7 acceptés sur 9, dont un après 18 minutes | Aucun rendu sur les 8 mesurés |
La réflexion ne comble pas l'écart
SenseNova progresse à peine sur les e-mails, Gemma progresse davantage. En allemand et en néerlandais, SenseNova continue d'inventer des mots.
Gemma 4 12B réfléchit sans fin sur les traductions
Il remplit tout le budget de réflexion, plus de 30 000 caractères pour un seul bloc, et ne rend aucune traduction. Avec la température conseillée par Google (1,0), c'est pareil. Pour traduire, il faut lui couper la réflexion.
Réfléchir coûte cher en temps
Un e-mail passe de quelques secondes à plus d'une minute et demie. Sur une question simple, SenseNova réfléchit plus court que Gemma (683 jetons contre 2 460), mais il va trois fois moins vite : 49 secondes contre 54.
Pourquoi un modèle annoncé au niveau d'un modèle de 27 milliards de paramètres fait-il moins bien ici ? Nos hypothèses, que nous n'avons pas vérifiées :
Les boucles ajoutent du calcul, pas du savoir
Repasser deux fois dans les mêmes couches aide à raisonner, mais le vocabulaire et les langues restent ceux d'un modèle de 9 milliards de paramètres.
Les tests publiés ne ressemblent pas à nos tâches
Ils portent surtout sur le code, les agents et l'analyse de données, en anglais ou en chinois. C'est loin de la rédaction en français, en allemand et en néerlandais.
Notre banc a été mis au point avec Gemma
Cela l'avantage un peu. La compression en 4 bits et la toute jeune version de llama.cpp de SenseTime peuvent aussi coûter quelques points à SenseNova.
Ce que disent les scores de SenseTime
SenseTime ne compare pas son modèle à Gemma 4 12B ni à Qwen3.5 9B. Il le compare à Qwen3.8-27B, trois fois plus gros, sur sept tests qu'il a choisis, surtout en anglais : jeu égal ou mieux sur quatre, un peu en dessous sur trois. Notre test, en français et sur nos propres tâches, donne une image beaucoup moins flatteuse.
| Test (scores publiés par SenseTime) | SenseNova-Loop-9B | Qwen3.8-27B |
|---|---|---|
| GAIA (assistant avec outils) | 69,9 | 67,0 |
| BIRD (requêtes SQL) | 72,3 | 69,8 |
| AIDABench (analyse de données) | 65,3 | 65,0 |
| AutomationBench (automatisation) | 36,7 | 36,7 |
| Terminal-Bench 2.1 (travail en ligne de commande) | 59,6 | 63,4 |
| NL2Repo (écrire un projet de code) | 41,4 | 44,6 |
| τ³-Banking (agent de service client) | 30,9 | 36,1 |
Scores donnés par SenseTime dans un graphique de la fiche du modèle, mesurés avec ses propres réglages : un ordre de grandeur, pas un classement indépendant.
La mémoire et la machine
| Précision des poids | Mémoire GPU | Machine |
|---|---|---|
| Q4 (4 bits), contexte de 8 192 jetons | 5,9 Go mesurés | CoreIA RTX 5060 Ti |
| Q4 (4 bits), contexte de 32 768 jetons | 8,6 Go estimés | CoreIA RTX 5060 Ti |
| Q8 (8 bits), contexte de 32 768 jetons | 12,6 Go estimés | CoreIA RTX 5060 Ti |
| FP16 (16 bits), contexte de 32 768 jetons | 20,8 Go estimés | CoreIA RTX 5090 |
Les estimations de Radiance Systems sont prudentes : elles comptent un cache séparé pour chaque passage des couches répétées, et une marge de fonctionnement. Notre mesure en 4 bits est nettement plus basse.
| Machine | Mémoire GPU | Prix HT | SenseNova-Loop-9B |
|---|---|---|---|
| CoreIA RTX 5060 Ti | 16 Go | 1 735 € | Oui, en 4 ou 8 bits. C'est la carte de notre test. |
| CoreIA RTX 5090 | 32 Go | 9 403 € | Oui, même en 16 bits. Non testé sur cette carte. |

Voir la CoreIA RTX 5060 Ti
L'installation, à ce jour
Au 19 novembre 2026, ni Ollama ni LM Studio ne lisent ce modèle. Il faut compiler la version de llama.cpp publiée par SenseTime, et il n'en existe pas de version prête pour Windows. Nous l'avons compilée sous Ubuntu dans Windows (WSL). Trois pièges :
Le bon commit
La version citée par la fiche du modèle n'est pas sur la branche principale du dépôt : il faut la récupérer à part.
L'interface web
Le téléchargement de l'interface web échoue pendant la compilation. Il faut la désactiver : le serveur fonctionne très bien sans.
Les RTX 50
Il faut CUDA 12.8 ou plus récent, et compiler pour l'architecture des RTX 50.
Si vous achetez une machine chez nous, nous l'installons pour vous.
La licence
La licence est Apache 2.0 : usage commercial permis, sans seuil de chiffre d'affaires, en gardant la licence et les mentions d'origine. Les poids originaux se téléchargent après une demande d'accès sur Hugging Face, accordée automatiquement ; la version GGUF est en accès libre.
Résumé de la licence indiquée sur la fiche du modèle. Ce n'est pas un avis juridique.
Notre verdict
Sur une RTX 5060 Ti 16 Go, SenseNova-Loop-9B tient sans problème, mais ne tient pas ses promesses face à Gemma 4 12B. Il est trois fois plus lent en génération, quatre fois plus lent pour lire un long texte, et moins fiable sur des tâches réelles en français, en allemand et en néerlandais.
Son architecture échange de la mémoire contre du calcul. Or, sur une carte de 16 Go, la mémoire n'est pas ce qui manque pour un modèle de cette taille : le compromis joue contre lui. Il pourrait devenir intéressant quand llama.cpp et Ollama auront optimisé ses opérations. Pour l'instant, sur cette carte, Gemma 4 12B reste notre choix.
Si vous cherchez encore plus petit, pour des agents simples, voyez notre article sur LFM3.
Quel modèle pour votre usage ?
Dites-nous ce que vous voulez automatiser. Nous vous disons quel modèle convient et sur quelle machine. Devis gratuit, sans engagement.
Questions fréquentes
SenseNova-Loop-9B tient-il sur une RTX 5060 Ti 16 Go ?
Oui. Nous avons mesuré environ 5,9 Go de mémoire GPU en 4 bits avec un contexte de 8 192 jetons. Il reste beaucoup de place sur la carte.
Quelle vitesse sur une RTX 5060 Ti 16 Go ?
Nous avons mesuré 16 jetons par seconde en génération, contre 48 pour Gemma 4 12B sur la même carte. Ce sont nos mesures du 19 novembre 2026, avec une version de logiciel toute récente.
Est-il meilleur que Gemma 4 12B ?
Pas sur nos tâches. Il a réussi 52 tâches d'assistant sur 67, contre 67 sur 67 pour Gemma 4 12B, et Gemma a gagné 22 tâches sur 33 notées à l'aveugle, contre 6 pour SenseNova et 5 égalités.
La réflexion activée change-t-elle le résultat ?
Non. Avec la réflexion, SenseNova passe de 3,3 à 3,4 sur 5 sur nos e-mails, et Gemma 4 12B de 3,8 à 4,1. En revanche, Gemma ne rend plus ses traductions quand il réfléchit : il faut lui couper la réflexion pour traduire.
Pourquoi parle-t-on de 14,6 milliards de paramètres ?
Le modèle exécute deux fois une partie de ses couches : il calcule comme un modèle d'environ 14,6 milliards de paramètres, mais n'en stocke que 9,4 milliards. C'est ce dernier chiffre qui compte pour la mémoire, et le premier qui explique sa lenteur.
Fonctionne-t-il avec Ollama ?
Pas encore au 19 novembre 2026. Il faut compiler la version de llama.cpp publiée par SenseTime.
Peut-on l'utiliser dans une entreprise ?
Oui. La licence est Apache 2.0 : usage commercial permis, en gardant la licence et les mentions d'origine.
Sources : test de Radiance Systems du 19 novembre 2026 sur RTX 5060 Ti 16 Go ; SenseTime, fiche de SenseNova-Loop-9B ; fichiers GGUF officiels ; llama.cpp de SenseTime ; licence Apache 2.0.
Parlons de votre projet d’IA locale
Par téléphone ou en visio, on regarde ensemble ce dont vous avez besoin. Vous repartez avec une recommandation claire, sans engagement.
- L’ordinateur ou le serveur IA adapté à votre usage et à votre équipe
- Ce qu’il faut développer pour vous, si besoin : automatisations, applications, recherche dans vos documents
- Le budget et les délais, avec un devis sous 24 h
Appel en français, en anglais ou en néerlandais.
C’est réservé !