Une ou deux cartes graphiques pour l'IA locale ? Guide multi-GPU 2026
Deux cartes graphiques.
Pas deux fois plus vite.
Le multi-GPU sert à autre chose. Voici quoi, et combien de cartes configurer selon votre usage.
C'est la question que se posent tous ceux qui montent en gamme : plutôt que d'acheter une carte plus chère, pourquoi ne pas en mettre deux ? L'intuition est simple. Elle est aussi largement fausse, pour une raison mécanique qu'il faut comprendre avant de dépenser.
Le mythe des deux cartes
Pourquoi votre conversation n'ira pas plus vite
En génération de texte, un modèle produit un token à la fois. Pour chaque token, il relit l'intégralité de ses poids depuis la mémoire vidéo. La vitesse dépend donc de la bande passante d'une seule carte, pas de leur nombre.
Quand un modèle est réparti sur deux cartes, les couches sont traitées en séquence : la première carte calcule sa partie, transmet le résultat, la seconde prend le relais. À tout instant, une seule carte travaille. L'autre attend.
Résultat : un modèle réparti sur deux cartes tourne à peu près à la vitesse d'une seule, avec un léger surcoût de communication. Ce n'est pas un défaut de configuration. C'est la nature du calcul.
Schéma simplifié de la répartition par couches. Chaque carte traite la moitié du modèle, à tour de rôle. Le nombre de tokens produits par seconde reste comparable à celui d'une carte seule.
Ce que deux cartes font vraiment
Ce que le multi-GPU apporte
- Une mémoire additionnée. Deux cartes de 32 Go permettent de charger un modèle de 64 Go. C'est le gain principal, et souvent le seul qui compte.
- Un débit multiplié en usage partagé. Plusieurs utilisateurs ou plusieurs agents en parallèle : chaque carte traite ses propres requêtes. Là, le gain est réel.
- Un contexte plus long. La VRAM libérée sert au cache de contexte, ce qui permet de longues fenêtres sur de gros modèles.
- Des tâches distinctes en parallèle. Un modèle de langage sur une carte, la génération d'images sur l'autre.
Ce que le multi-GPU ne fait pas
- Accélérer une conversation seule. Le débit en tokens par seconde suit la bande passante d'une carte.
- Partager la génération d'images. Les outils comme ComfyUI et les modèles vidéo ne se répartissent pas nativement sur plusieurs cartes.
- Remplacer une carte professionnelle pour l'entraînement. Sans NVLink, la synchronisation des gradients par PCIe freine fortement.
- Se contenter d'une carte mère classique. Les plateformes grand public partagent leurs lignes PCIe entre les deux cartes.
Combien de cartes configurer ? L'arbre de décision
Jusqu'où peut-on monter ? Les paliers de configuration
Le nombre de cartes que vous pouvez installer dépend de la plateforme, et surtout de ses lignes PCIe. C'est là que se joue la vraie différence entre une base grand public et une base professionnelle.
| Configuration | VRAM totale | Plateforme | Usage visé |
|---|---|---|---|
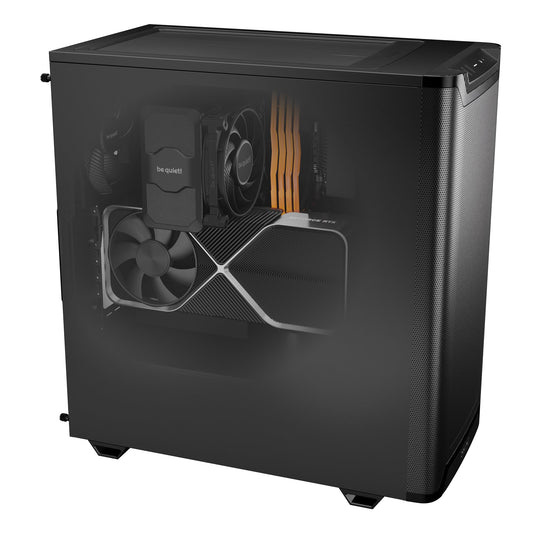
| 1 × RTX 5090 | 32 Go | Tour grand public | Usage individuel, modèles jusqu'à 70B en 4-bit |
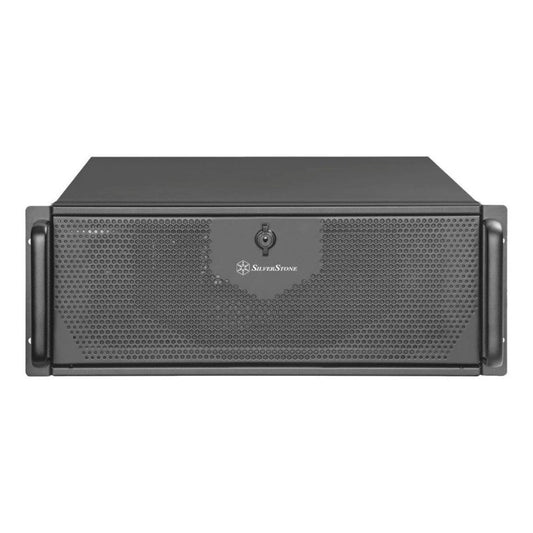
| 2 × RTX 5090 | 64 Go | Rack 4U, 2 000 W | Équipe, contextes longs sur gros modèles |
| 1 × RTX 6000 Blackwell | 96 Go ECC | Station ou rack | Gros modèles en solo, fine-tuning, ECC |
| 2 × RTX 6000 Blackwell | 192 Go ECC | Rack 4U, Threadripper PRO | Production, nombreux utilisateurs |
| 3 × RTX 6000 Blackwell | 288 Go ECC | Threadripper PRO, lignes PCIe complètes | Recherche, entraînement, très grands modèles |
| 4 × RTX PRO 6000 Blackwell | 384 Go ECC | Threadripper PRO, voire plus de cartes sur demande | Très grands modèles, plusieurs modèles en parallèle |
Quelle carte choisir avant de décider du nombre
Le choix du modèle de carte précède celui de la quantité. Voici comment se comparent les deux références, en configuration mono-carte puis en multi-carte. Les deux références sont disponibles dans notre gamme de machines IA, en version mono-carte comme en multi-carte.
| Critère | RTX 5090 (32 Go) | 2 × RTX 5090 (64 Go) | RTX 6000 Blackwell (96 Go) |
|---|---|---|---|
| VRAM totale | 32 Go | 64 Go | 96 Go |
| Modèle 70B en 4-bit | Tient, contexte court | Confortable | Large marge |
| Vitesse, utilisateur seul | Maximale | Comparable à une carte | Élevée, sans goulot |
| Plusieurs utilisateurs | Limité | Débit multiplié | Bon, mémoire partagée |
| Génération d'images et vidéo | Excellent | Une carte à la fois | Excellent |
| Fine-tuning | LoRA jusqu'à 13B env. | Freiné par PCIe | QLoRA sur 70B |
| Mémoire ECC | Non | Non | Oui |
| Extensible jusqu'à | 3 cartes au configurateur, 4 ou plus sur devis | 3 cartes au configurateur, 4 ou plus sur devis | 3 cartes au configurateur sur Threadripper PRO, 4 ou plus sur devis |
| Consommation GPU | 575 W | 1 150 W | 600 W |
Les coûts cachés d'une seconde carte
Le prix de la carte n'est que le début. Une configuration bi-GPU sérieuse implique quatre postes que les listes de composants oublient.
Les lignes PCIe
Les processeurs grand public n'offrent que 16 à 24 lignes PCIe. Avec deux cartes, une carte mère classique les partage en x8 et x8. C'est pourquoi une configuration à deux cartes passe chez nous en format rack, et pourquoi trois cartes exigent une plateforme Threadripper PRO, seule à disposer d'assez de lignes pour les alimenter pleinement.
L'alimentation
Une RTX 5090 consomme 575 W. À deux cartes, il faut une alimentation de 1 500 W minimum, et de préférence 2 000 W en Platinum. Au-delà, sur une configuration à trois cartes professionnelles, le dimensionnement électrique et thermique fait partie intégrante de l'étude que nous menons avec vous.
Le refroidissement et le boîtier
Deux cartes sous charge produisent deux fois plus de chaleur, dans un espace où elles se gênent mutuellement. Il faut un boîtier avec un flux d'air pensé pour, et souvent un format rack qui sépare physiquement les cartes.
La mémoire système
Le modèle transite par la RAM avant d'être chargé en VRAM. La règle pratique : au moins deux fois la VRAM totale en mémoire système. Pour 64 Go de VRAM, comptez 128 Go de RAM.
Comment les logiciels répartissent le modèle
Deux approches coexistent, et elles ne se valent pas.
La répartition par couches. C'est ce que font Ollama et llama.cpp automatiquement. Chaque carte reçoit une tranche du modèle et les traite en séquence. Peu de communication entre cartes, donc tolérant au PCIe, mais aucun gain de vitesse en solo. C'est le mode par défaut, et le bon choix sur du matériel grand public.
Le parallélisme tensoriel. C'est ce que propose vLLM. Chaque opération est découpée entre les cartes, qui travaillent simultanément. Un vrai gain de vitesse est possible, mais il exige beaucoup de bande passante entre cartes. Sans NVLink, le bénéfice reste modeste et dépend fortement des lignes PCIe disponibles.
Nos plateformes, configurables en nombre de cartes
Chaque machine est assemblée à la main à Auriol (13390) et entièrement configurable, y compris le nombre de cartes graphiques. Ajustez la configuration dans le configurateur en ligne, ou décrivez-nous votre usage pour un devis sur mesure à contact@radiancesystems.eu.
Station de travail, une carte
 CoreIA 64 : RTX 5090 32 GoLe choix par défaut en usage individuel. Carte graphique configurable selon votre besoin.
8 642 €
Rack, deux cartes
 CoreIA Rack : 2 × RTX 5090, 64 GoRack 4U, 128 Go de RAM, 2 000 W. Débit partagé et contextes longs.
17 887 €
CoreIA 128 Rack : 2 × RTX 6000, 192 Go ECCModèle 70B en précision native, dizaines d'utilisateurs, entraînement.
42 452 €
Threadripper PRO, de une à quatre cartes, voire plus sur demande
Pro IA Ultra : jusqu'à 4 × RTX PRO 6000 Blackwell96 à 288 Go de VRAM ECC au configurateur (1 à 3 cartes), 4 cartes ou plus sur devis. RAM extensible à 2 To.
26 890 €
L'alternative sans multi-GPU
 Mini serveur GB10 : 128 Go unifiésUne seule puce, une mémoire unique de 128 Go, 240 W. Aucun bus entre cartes à gérer.
6 299 €
En bref
Deux cartes graphiques rendent-elles l'IA locale plus rapide ?
Pas pour un utilisateur seul. La vitesse de génération suit la bande passante d'une carte, et les cartes travaillent à tour de rôle. Le gain réel est ailleurs : plus de mémoire, et un débit multiplié quand plusieurs personnes ou agents sollicitent le serveur en même temps.
Les RTX 5090 supportent-elles NVLink ?
Non. NVLink a disparu des cartes grand public depuis la RTX 3090. Deux RTX 5090 communiquent par PCIe, ce qui convient à l'inférence mais freine l'entraînement.
Faut-il deux RTX 5090 ou une RTX 6000 Blackwell ?
Pour la capacité en solo, la RTX 6000 : 96 Go sur une seule carte, sans échange entre cartes ni contrainte de plateforme, avec l'ECC. Pour le débit partagé entre plusieurs utilisateurs, deux 5090 gardent un intérêt.
Combien de cartes peut-on installer au maximum ?
Cela dépend de la plateforme. Une tour grand public accepte deux cartes, avec des lignes PCIe partagées. Notre station Pro IA Ultra, bâtie sur Threadripper PRO, accepte jusqu'à quatre RTX PRO 6000 Blackwell, voire plus, soit 384 Go de mémoire vidéo ECC avec quatre cartes : jusqu'à trois cartes se choisissent dans le configurateur, quatre ou plus sur devis.
Le nombre de cartes est-il figé à la commande ?
Non. Toutes nos machines sont configurables, y compris en nombre de cartes graphiques. Vous choisissez la configuration dans le configurateur en ligne ou sur devis, et vous pouvez démarrer avec une carte puis en ajouter plus tard si la plateforme le permet.
Peut-on mettre deux cartes dans un PC classique ?
Physiquement parfois, mais les lignes PCIe sont alors partagées en x8 et x8, et l'alimentation, le refroidissement et la mémoire système doivent suivre. C'est pourquoi nos configurations à deux cartes ou plus passent en format rack ou sur plateforme Threadripper PRO.
La génération d'images profite-t-elle de deux cartes ?
Pas nativement. ComfyUI et les modèles vidéo utilisent une carte à la fois. Deux cartes permettent en revanche de faire tourner un modèle de langage sur l'une et la génération d'images sur l'autre.
Les indications de ce guide sont des ordres de grandeur issus des documentations publiques et des retours de l'écosystème. Les performances réelles dépendent du moteur d'inférence, du mode de répartition, de la plateforme et du modèle utilisé. Pour un dimensionnement précis, contactez-nous.