PC für OpenClaw lokal: Welche Hardware soll ich wählen? | Radiance Systems
Teilen
OpenClaw ist ein Framework für KI-Agenten, das darauf ausgelegt ist, vollständig auf Ihrem Rechner zu laufen. Doch um seine volle Leistung – schnelle Inferenz, große Modelle, latenzfreie Pipelines – zu nutzen, ist Ihre Hardware genauso wichtig wie Ihre Softwarekonfiguration. Hier erfahren Sie alles, was Sie wissen müssen.
Von Radiance Systems Team · · 8 Min. Lesezeit
- OpenClaw funktioniert 100 % offline, sobald die Modelle heruntergeladen sind – keinerlei Cloud-Abhängigkeit.
- Das Minimum für eine reibungslose Nutzung: eine NVIDIA-GPU mit mindestens 16 GB VRAM.
- Für Modelle über 30B+ zielen Sie auf eine GPU mit 24–32 GB VRAM oder ein Multi-GPU-System ab.
- System-RAM: mindestens 32 GB DDR5 für gemischte KI- und Büroarbeitslasten.
- Radiance CoreAI Workstations werden vorkonfiguriert mit CUDA, Ollama und der Umgebung, die für OpenClaw bereit ist, geliefert.
- Keine Abonnements, keine Kosten pro Token: Ihre KI gehört Ihnen.
Was ist OpenClaw und warum sollte man es lokal ausführen?
OpenClaw ist ein Open-Source-Framework zur Orchestrierung von KI-Agenten. Es ermöglicht Ihnen, Sprachmodelle (LLMs) direkt in Ihrer Infrastruktur bereitzustellen, zu verketten und mit ihnen zu interagieren – ohne eine Drittanbieter-API zu nutzen, ohne Ihre Daten an entfernte Server zu senden.
Das Versprechen ist einfach: Sie behalten die vollständige Kontrolle über Ihre KI-Pipeline. Ihre Dokumente, Anfragen und Antworten verlassen niemals Ihr Netzwerk. Für Fachleute, die der DSGVO, dem Berufsgeheimnis oder der juristischen Ethik unterliegen, ist dies ein grundlegender Paradigmenwechsel.
Doch OpenClaw ist ressourcenintensiv. Es basiert auf LLM-Modellen, die im GPU-Speicher geladen werden, und seine Leistung hängt direkt von Ihrer Hardware ab. Ein Consumer-PC oder ein Laptop wird den Anforderungen nicht lange standhalten.
Welche PC-Konfiguration für OpenClaw lokal?
OpenClaw orchestriert Agenten, die LLM-Modelle in der Inferenz aufrufen. Diese Modelle bestimmen die Hardware-Anforderungen. Hier sind die Schwellenwerte, die Sie kennen sollten:
Die GPU: das Herzstück
Der VRAM (Videospeicher) bestimmt, welche Modelle Sie laden können und wie schnell sie Tokens generieren. Dies ist der limitierende Faktor Nummer eins.
NVIDIA-GPUs werden aufgrund des CUDA-Ökosystems bevorzugt, das für Frameworks wie llama.cpp, Ollama oder vLLM, die OpenClaw antreiben, unerlässlich ist. Die RTX 5000-Serie (Blackwell-Architektur) bietet derzeit das beste Verhältnis von Leistung zu VRAM für Workstations.
Der System-RAM
RAM wird für lange Kontexte, Embeddings und parallele Pipelines verwendet. Unter 32 GB DDR5 riskieren Sie Engpässe bei komplexen Workflows.
Der Speicher
LLM-Modelle sind groß: von 4 GB für ein quantisiertes 7B-Modell bis zu über 80 GB für ein 70B-Modell mit voller Präzision. Planen Sie eine NVMe-SSD von mindestens 2 TB ein, wenn Sie mehrere Modelle gleichzeitig speichern möchten.
Schritt-für-Schritt-Installationsanleitung für OpenClaw auf Ihrem PC
Hier ist der vollständige Prozess, um OpenClaw unter Windows 11 oder Ubuntu betriebsbereit zu machen. Radiance CoreAI Workstations werden mit vorinstallierten CUDA-Treibern und Ollama geliefert, was diesen Prozess auf 3–4 Schritte reduziert.
Stellen Sie sicher, dass Ihr NVIDIA-Treiber aktuell ist (Version ≥ 525) und das CUDA Toolkit installiert ist. Überprüfen Sie dies mit nvidia-smi im Terminal. Auf Radiance-Maschinen ist dies bereits erledigt.
OpenClaw stützt sich auf Ollama, um Modelle lokal zu laden und bereitzustellen. Installieren Sie es von ollama.com oder über das Terminal: curl -fsSL https://ollama.com/install.sh | sh. Unter Windows reicht der GUI-Installer aus.
Im Terminal: ollama pull mistral für ein 7B-Modell oder ollama pull qwen2.5:32b für ein leistungsstärkeres Modell. Der Download erfolgt nur einmal.
Klonen Sie das offizielle OpenClaw-Repository, installieren Sie die Python-Abhängigkeiten (venv empfohlen) und konfigurieren Sie dann config.yaml, um auf Ihren lokalen Ollama-Endpunkt (http://localhost:11434) zu verweisen.
Starten Sie Ollama im Hintergrund (ollama serve) und dann OpenClaw. Ihr erster KI-Agent läuft vollständig auf Ihrer Maschine – keine Daten verlassen Ihr Netzwerk.
Fügen Sie eine RAG-Schicht hinzu, indem Sie Ihre PDFs, Word-Dokumente oder lokalen Datenbanken indizieren. OpenClaw kann Ihre internen Dokumente in natürlicher Sprache abfragen – Berufsgeheimnis garantiert.
Hardware-Vergleich: Welche Workstation für welchen OpenClaw-Einsatz?
Nicht alle PCs sind OpenClaw gegenüber gleich. Diese Tabelle fasst die Schlüsselkriterien nach Nutzungsprofilen zusammen.
| Nutzungsprofil | Benötigter VRAM | System-RAM | Unterstützte Modelle | Empfohlene Stufe |
|---|---|---|---|---|
| Leichte Einzelnutzung — 1 Agent, gelegentliche Nutzung | 16 GB | 16–32 GB | 7B–13B Mistral, LLaMA 3.1 |
CoreAI 16 |
| Regelmäßige professionelle Nutzung — RAG, Multi-Docs, komplexe Agenten | 16–24 GB | 32 GB | 13B–30B quantisiert Qwen 2.5, DeepSeek |
CoreAI 32 |
| Mehrbenutzer-Kanzlei — gleichzeitige Inferenz | 32 GB | 64 GB | 70B quantisiert Mixtral, Qwen 72B |
CoreAI 64 |
| Multi-Agenten-Produktion 24/7 — Fine-Tuning | 64–96 GB (Multi-GPU) | 128 GB | 70B+ voll / 200B Fine-Tuning möglich |
Rack 2×5090 / GB10 |
Hinweis zur Quantisierung: 4-Bit- oder 8-Bit-GGUF-Modelle können ein 30B-Modell mit 16 GB VRAM ausführen, mit einem leichten Qualitätsverlust. Für kritische professionelle Anwendungen bevorzugen Sie die maximale Präzision – was eine korrekte Dimensionierung Ihrer GPU impliziert.
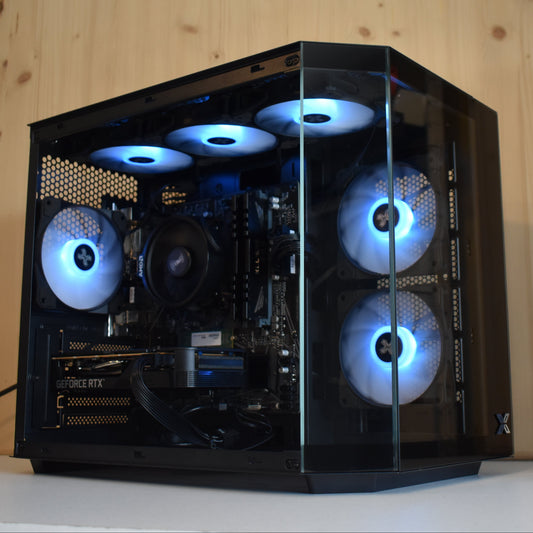
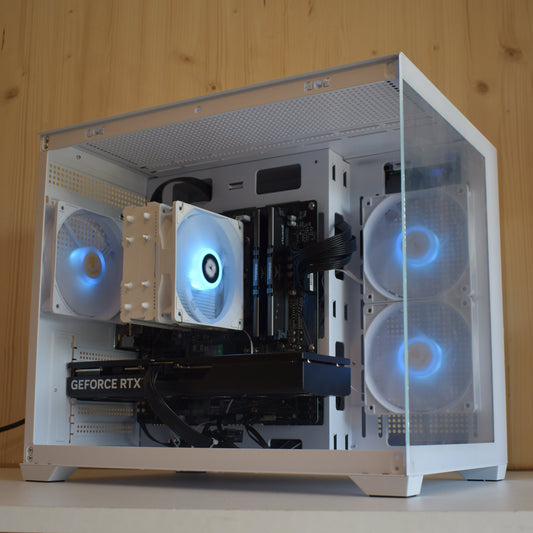
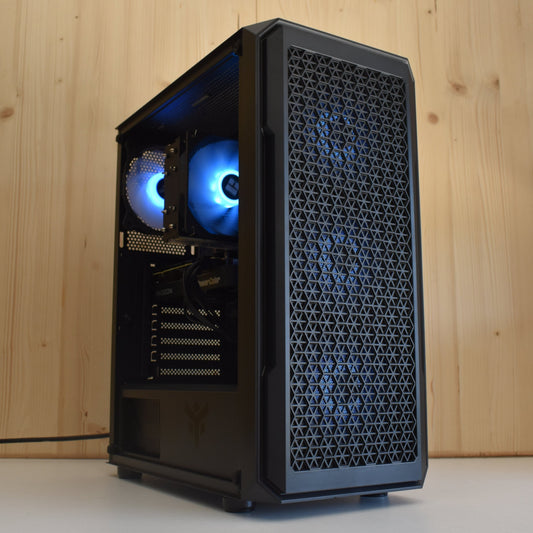
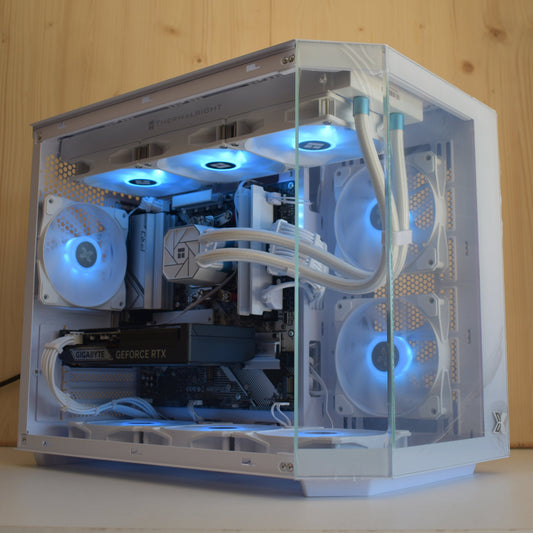
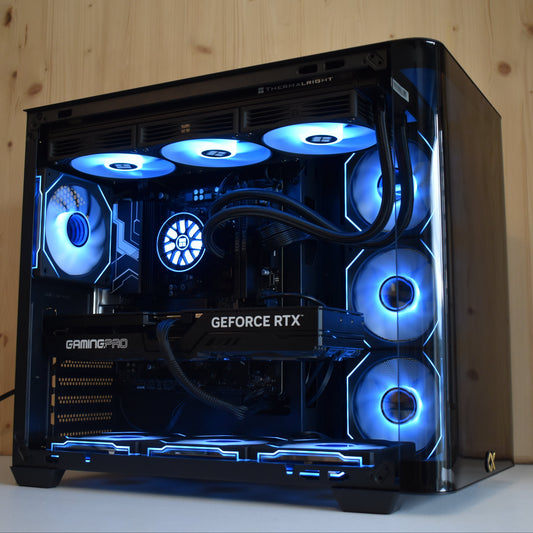
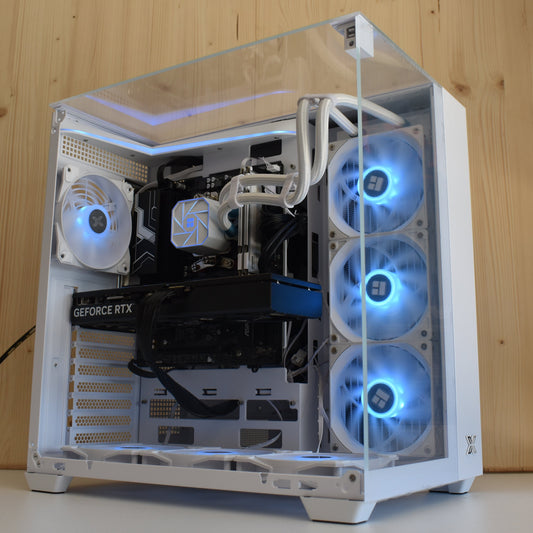
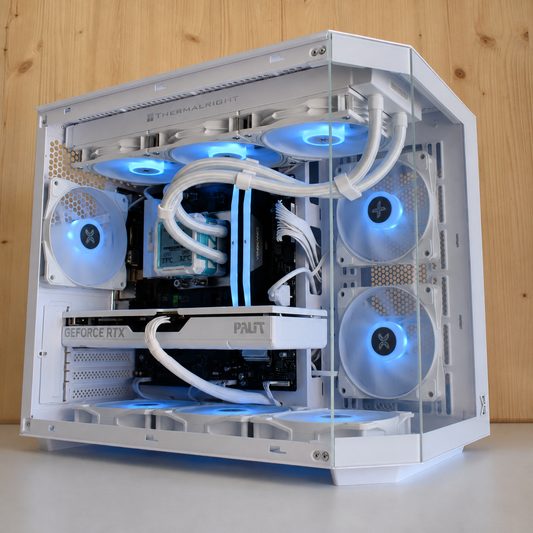
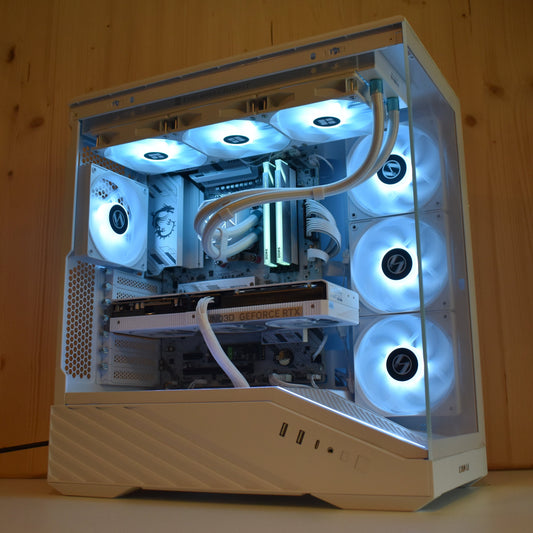
Die Radiance-Maschinen, bereit für OpenClaw
Jede Maschine wird in Auriol (13) zusammengebaut, vorkonfiguriert und betriebsbereit geliefert. CUDA-Treiber, Ollama und Python-Umgebung sind bereits eingerichtet.
Welche LLM-Modelle mit OpenClaw lokal verwenden?
OpenClaw ist kompatibel mit jedem Modell, das über eine OpenAI-kompatible API bereitgestellt wird – dazu gehören Ollama, llama.cpp, LM Studio oder vLLM. Unsere Auswahl 2025:
| Modell | Größe | Benötigter VRAM | Stärken | Zielprofil |
|---|---|---|---|---|
| Mistral Small 3.1 | 24B | ~14 GB (Q4) | Schnell, mehrsprachig, präzise Anweisungen | Allgemeine Nutzung, Assistenten |
| Qwen 2.5 / Qwen3 | 7B–72B | 4–40 GB | Hervorragend in Französisch, starke Argumentation | Recht, Medizin, Buchhaltung |
| DeepSeek-R1 | 7B–70B | 4–38 GB | Kettenlogik, Code, Analyse | F&E, Ingenieurbüros |
| LLaMA 3.3 | 70B | ~38 GB (Q4) | Referenzmodell, vielseitig | Jeder professionelle Einsatz |
| Gemma 3 | 9B–27B | 5–16 GB | Leicht, multimodal, leistungsstark auf kleinen GPUs | Einzelkanzleien, Medizin |
Für den professionellen Einsatz in deutscher Sprache bieten Qwen 2.5 32B und Mistral Small 3.1 das beste Gleichgewicht zwischen Antwortqualität und Inferenzgeschwindigkeit auf einer 16–24 GB GPU.
Lokale KI vs. Cloud: Die entscheidenden Argumente für Profis
| Kriterium | Lokale KI (OpenClaw + Radiance) | Cloud-KI (ChatGPT, Copilot…) |
|---|---|---|
| Datenvertraulichkeit | ✓ Total – nichts geht nach außen | ✗ Datenübertragung an den Anbieter |
| DSGVO-Konformität | ✓ Nativ – keine Übertragung außerhalb der EU | ⚠ Variabel je nach DPA-Verträgen |
| Kostenmodell | Einmalinvestition | Abonnement + Abrechnung pro Token |
| Offline-Verfügbarkeit | ✓ Funktioniert ohne Internet | ✗ Benötigt ständige Verbindung |
| Personalisierung / Fine-Tuning | ✓ Vollständig mit Ihren Daten | Begrenzt je nach Angebot |
| Berufsgeheimnis | ✓ Konzeptionell gewährleistet | ⚠ Reales ethisches Risiko |
Radiance-Erfahrung: Unsere Profi-Tipps für OpenClaw
Wir assemblieren und deployen KI-Workstations von Auriol aus für Profis in ganz Europa. Das haben wir aus unseren Praxiserfahrungen gelernt:
💡 Unterschätzen Sie nicht die NVMe-Bandbreite
Beim Start lädt OpenClaw das Modell von der Festplatte in den VRAM. Eine NVMe Gen 4 (~7.000 MB/s) reduziert diese Ladezeit um 40 bis 70 % im Vergleich zu einer SATA-SSD. Auf unseren CoreAI-Maschinen ist standardmäßig Gen 4 verbaut.
💡 Begrenzen Sie das Kontextfenster, wenn Ihnen VRAM fehlt
OpenClaw kann lange Kontexte (32K, 128K Tokens) öffnen. Jedes Kontext-Token verbraucht VRAM. Auf einer 16-GB-GPU begrenzen Sie auf 8K–16K Tokens, um eine schnelle Generierung zu gewährleisten. Auf einer 32-GB-GPU ist 128K problemlos zugänglich.
💡 Aktivieren Sie Flash Attention, wenn Ihre GPU dies unterstützt
Die RTX 5000 (Blackwell) unterstützen nativ Flash Attention 3, was den Speicherbedarf für lange Kontexte um 30 bis 50 % reduziert. Aktivieren Sie dies in Ihrer Inferenz-Backend-Konfiguration.
💡 Für eine Multi-User-Kanzlei: OpenClaw als interne API bereitstellen
Anstatt OpenClaw auf jedem Arbeitsplatz zu installieren, stellen Sie eine Serverinstanz auf einer Radiance Rack Workstation bereit, die über Ihr lokales Netzwerk zugänglich ist. Alle Ihre Mitarbeiter verbinden sich lokal, die Daten bleiben vor Ort, und Sie nutzen die GPU-Leistung gemeinsam.
Häufig gestellte Fragen zu OpenClaw lokal
Ist OpenClaw schwer zu installieren?
Auf einem Standardcomputer erfordert die Installation Grundkenntnisse in Terminal und Python. Auf Radiance CoreAI Workstations ist die Umgebung (CUDA, Ollama, Python) vorkonfiguriert, was die Installation auf etwa zehn Minuten reduziert. Unser Team kann die Ersteinrichtung auch remote durchführen.
Kann man mit OpenClaw lokales Fine-Tuning durchführen?
OpenClaw ist ein Agenten-Orchestrator, kein Fine-Tuning-Tool. Um ein Modell an Ihre Daten anzupassen, benötigen Sie ein spezielles Tool (Axolotl, LLaMA-Factory) und eine GPU mit mindestens 24 GB VRAM für 7B-Modelle oder ein Multi-GPU-System für größere Modelle. Unsere Konfigurationen Rack 2×RTX 5090 und RTX 6000 PRO Blackwell sind für diesen Zweck dimensioniert.
Läuft OpenClaw unter Windows?
Ja, OpenClaw unterstützt Windows über WSL2 oder native Python-Installation. Unsere CoreAI-Maschinen werden mit Windows 11 Pro und voraktiviertem WSL2 ausgeliefert, was eine vollständige Kompatibilität mit dem Ökosystem der Open-Source-KI-Tools gewährleistet.
Was ist der Unterschied zwischen OpenClaw und Open WebUI?
Open WebUI ist eine grafische Benutzeroberfläche zur Interaktion mit Modellen über einen Chat. OpenClaw ist ein Framework für KI-Agenten – es automatisiert komplexe Aufgaben, verknüpft Modellaufrufe, integriert externe Tools und kann in mehreren Schritten Schlussfolgerungen ziehen. Beide können auf derselben Maschine koexistieren.
Meine Kanzlei unterliegt strengen DSGVO-Verpflichtungen. Ist lokale KI wirklich konform?
Ja. Sobald die Verarbeitung personenbezogener Daten auf Ihrer Hardware, in Ihren Räumlichkeiten und ohne Übertragung an einen Drittanbieter erfolgt, sind Sie mit dem Grundsatz der Datenminimierung und Datensouveränität der DSGVO konform. Radiance Workstations sind präzise darauf ausgelegt, diese Architektur standardmäßig zu gewährleisten.
Ihr PC für OpenClaw lokal, montiert in Auriol
Nennen Sie uns Ihren Anwendungsbereich, Ihre Tätigkeit, Ihre Zielmodelle. Wir konfigurieren die ideale Maschine und senden sie Ihnen innerhalb von 4 bis 10 Werktagen einsatzbereit zu.
Kostenloses Angebot anfordern →