Lokale KI-Entwicklung und -Automatisierung auf GB10 und DGX Spark
Die Hardware macht 20 % aus.
Was wir darauf aufbauen, macht 80 % aus.
Wir verkaufen nicht nur KI-Workstations. Wir entwickeln die Automatisierungen, die sie nützlich machen.
Ein GB10-Server, der einfach nur auf dem Schreibtisch steht, leistet von allein nichts. Er wird erst dann wertvoll, wenn Sie Ihre Dokumente, Ihre Prozesse und Ihre täglichen Arbeitsabläufe damit verknüpfen.
Das ist unsere zweite Kernkompetenz: diese Automatisierungen konzipieren und entwickeln, und zwar vollständig lokal auf der Maschine, die wir Ihnen liefern.
Die drei Stufen der KI-Automatisierung
Nicht jedes Unternehmen startet am selben Punkt. Hier sind die drei Ebenen, die uns am häufigsten begegnen – vom einfachsten bis zum anspruchsvollsten Niveau.
Der KI-Chat-Assistent
Der Startpunkt. Eine Web-Oberfläche, die von jedem Arbeitsplatz aus zugänglich ist, mit Ihren installierten Modellen und indizierten Dokumenten.
Ihre Teams können Fragen stellen, Texte verfassen, zusammenfassen und Ihre Dokumentenbasis abfragen. Es ist das Äquivalent zu einem Consumer-Tool, jedoch bei Ihnen gehostet.
Diese Stufe wird bereits konfiguriert mit der Maschine geliefert. Sie erfordert keine spezifische Entwicklung. Sie ist für jede unserer KI-Stationen und -Server verfügbar, vom GB10 bis hin zu Rack-Servern.
Automatisierte Workflows
Hier wartet die KI nicht mehr darauf, dass man ihr eine Frage stellt. Sie wird bei einem Ereignis automatisch aktiv.
Ein Dokument geht ein, ein Formular wird ausgefüllt, eine bestimmte Zeit ist erreicht: Eine Verarbeitungskette startet, ruft das lokale Modell auf, erstellt ein Ergebnis und verteilt es an die richtige Stelle.
Wir bauen diese Ketten mit n8n, einem Orchestrator, den wir auf Ihrer Maschine hosten. Alles bleibt lokal, einschließlich der Daten, die zwischen den Schritten übertragen werden.
Die maßgeschneiderte Fachanwendung
Die höchste Stufe. Wenn kein Tool auf dem Markt Ihren Prozessen entspricht, entwickeln wir eine dedizierte Anwendung.
Eine auf Ihr Unternehmen angepasste Schnittstelle, deterministische Berechnungen dort, wo sie nötig sind, und der Aufruf des lokalen Modells nur dort, wo es einen Mehrwert bietet. Alles auf Ihrer Maschine installiert, ohne externe Abhängigkeiten.
Entwicklung in Python, mit der für Ihre Anwendung passenden Oberfläche: Desktop-App, interne Web-Schnittstelle oder Integration in bestehende Tools.
Der von uns installierte Tech-Stack
Ein Blick auf die Ebenen, die wir auf einer GB10- oder DGX Spark-Station einrichten – von der Hardware bis zu Ihrer täglichen Anwendung.Jede Ebene ist mit Docker containerisiert. Dies ermöglicht die Aktualisierung einer Komponente, ohne andere zu beeinträchtigen, und erlaubt die identische Replikation der Installation auf einer zweiten Maschine.
Beispiele unserer Arbeit
Hier sind einige Arten von Projekten, anonymisiert dargestellt.
Automatisierte Rechnungsstellung
Eine Bestellung in einem Online-Shop wird bestätigt. Ein Webhook löst die Dokumentengenerierung aus, kümmert sich um das Layout und sendet das Dokument automatisch per E-Mail an den Kunden.
n8n, Dokumentengenerierungsdienst, Mail-Server, alles in Docker-Containern.
Fachanwendung mit Transkription und Texterstellung
Ein Fachmann zeichnet eine Sitzung auf. Die Anwendung transkribiert das Audio lokal, trägt numerische Daten in ein strukturiertes Formular ein, berechnet Kennzahlen durch deterministischen Code und lässt die erzählenden Abschnitte vom lokalen Modell schreiben. Das finale Dokument wird direkt zur Korrektur bereitgestellt.
Python, lokales Whisper, überprüfbare Berechnungen, lokales Sprachmodell, Dokumentengenerierung.
Abfragbare Dokumentenbasis
Hunderte interne Dokumente werden auf der Maschine zerteilt, vektorisiert und indexiert. Teams können den gesamten Bestand in natürlicher Sprache abfragen und erhalten Antworten mit direktem Verweis auf die Quelldokumente.
Ingestion-Pipeline, Vektordatenbank, lokales Embedding-Modell, Chat-Interface.
Automatisierte Überwachung und Mahnungen
Ein Skript prüft ein Postfach, identifiziert Vorgänge ohne Antwort innerhalb eines definierten Zeitraums, bereitet Mahnungen vor und sendet eine zusammenfassende Benachrichtigung an den internen Messenger des Teams.
Python, E-Mail-Zugriff, Zeitplanung, Benachrichtigung via Telegram oder Unternehmens-Messenger.
Warum das GB10 eine ideale Basis ist
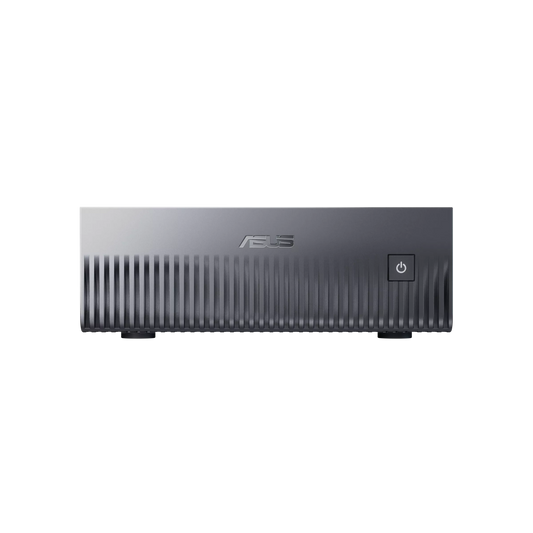
Die NVIDIA GB10-Plattform, auch bekannt als DGX Spark oder ASUS Ascent GX10, hat ein entscheidendes Merkmal für diese Art von Projekten: 128 GB Unified Memory.
Konkret ermöglicht dies den simultanen Betrieb mehrerer Komponenten, die sich auf einer klassischen Grafikkarte den Videospeicher streitig machen würden: ein großes Sprachmodell, ein Embedding-Modell für die Dokumentensuche, eine Transkriptions-Engine und die Anwendungs-Container.
Zwei weitere Vorzüge zählen für eine Maschine, die im Dauerbetrieb läuft: ein Stromverbrauch von rund 240 W und ein kompaktes, leises Format, das es ermöglicht, das Gerät im Büro statt in einem Technikraum aufzustellen.

NVIDIA GB10 KI-Mini-Server
- Chip NVIDIA GB10 Grace Blackwell
- Speicher 128 GB LPDDR5X Unified
- Leistung 1 PetaFLOP in FP4
- System DGX OS, Docker sofort einsatzbereit
- Verbrauch ca. 240 W
- Format 150 × 150 × 51 mm
Ablauf einer Zusammenarbeit
- Erstgespräch. Wir identifizieren den zu automatisierenden Prozess, das Volumen und die Vertraulichkeitsanforderungen. Unverbindlich.
- Anforderungsdefinition und Angebot. Wir beschreiben präzise, was geliefert wird, die benötigte Hardware und die Kosten. Sie geben grünes Licht, bevor wir starten.
- Entwicklung. Wir erstellen die Lösung und testen sie auf einer Maschine, die Ihrer entspricht.
- Installation. Vor Ort oder remote, nach Ihrem Wunsch, mit vorkonfigurierter Umgebung.
- Schulung. Einweisung für die Mitarbeiter, die das Tool täglich nutzen werden.
- Betreuung. Anpassungen, Erweiterung des Index, Modell-Updates und spätere Weiterentwicklungen.
Weitere für diese Entwicklungen geeignete Maschinen
 CoreIA 32 — RTX 5070 Ti 16 GBEinfache Automatisierungen und Dokumentenbasis moderater Größe.
2.862 €
CoreIA 64 — RTX 5090 32 GBHoher Durchsatz für rechenintensive Aufgaben und Massentranskription.
8.642 €
 CoreIA Rack — 2 × RTX 5090 (64 GB)Teamweite Automatisierungen, parallele Verarbeitung.
17.887 €
CoreIA 128 Rack — 2 × RTX 6000 (192 GB ECC)Dauerbetrieb, viele Nutzer, ECC-Zuverlässigkeit.
42.452 €
Für ein Gespräch über ein Automatisierungsprojekt schreiben Sie uns an contact@radiancesystems.eu. Wir antworten innerhalb von 3 Arbeitsstunden auf Französisch, Englisch oder Niederländisch.
Häufige Fragen
Was macht Radiance Systems über den Hardware-Verkauf hinaus?
Wir entwickeln die Automatisierungen, die auf den Maschinen laufen: n8n-Workflows, maßgeschneiderte Python-Anwendungen, abfragbare Dokumentendatenbanken, Transkriptions- und Texterstellungsketten. Alles läuft lokal, ohne Datenübertragung an externe Dienste.
Was sind GB10 und DGX Spark?
Es handelt sich um dieselbe NVIDIA-Hardware-Plattform, die auf dem GB10 Grace Blackwell Chip basiert und über 128 GB Unified Memory verfügt. DGX Spark ist der Name des NVIDIA-Referenzdesigns; ASUS Ascent GX10 ist eine Ausführung davon. Dieser vereinte Speicher erlaubt den gleichzeitigen Betrieb mehrerer KI-Komponenten auf einer einzigen kompakten Maschine.
Warum n8n statt eines Online-Automatisierungsdienstes nutzen?
Weil n8n auf Ihrer eigenen Maschine gehostet werden kann. Online-Automatisierungsdienste leiten Ihre Daten über ihre Server. Mit einer lokalen n8n-Installation bleiben Dokumente, Nachrichten und Ergebnisse in Ihrer Infrastruktur.
Kann man lokale KI mit bestehenden Tools verbinden?
Ja, in den meisten Fällen. E-Mail, Dateispeicher, Online-Shop, interne Tools mit Programmierschnittstelle: Dies sind die üblichen Verbindungspunkte eines Workflows. Die Machbarkeit prüfen wir bei der Anforderungsdefinition.
Was kostet eine maßgeschneiderte Entwicklung?
Dies hängt vollkommen vom Umfang ab. Eine einfache Automatisierung erfordert einige Tage Arbeit; eine vollständige Fachanwendung benötigt mehr. Wir erstellen nach der ersten Bedarfsanalyse ein präzises Angebot, bevor eine Verpflichtung Ihrerseits entsteht.
Muss man die Maschine bei Ihnen kaufen, um die Entwicklung zu nutzen?
Das ist nicht zwingend, aber einfacher. Wenn wir die Maschine liefern, beherrschen wir die gesamte Umgebung und können die Lösung vor der Auslieferung auf einer identischen Konfiguration testen. Anfragen zu bestehenden Infrastrukturen prüfen wir jedoch gerne.
Was passiert, wenn sich unsere Bedürfnisse ändern?
Die Lösungen sind auf Wachstum ausgelegt. Dokumente zum Index hinzufügen, einen Schritt im Workflow ändern oder ein Modell durch eine neuere Version ersetzen ist Teil der Betreuung, die wir anbieten.
Die präsentierten Beispiele beschreiben Arten von Projekten und wurden bewusst anonymisiert. Umfang, Dauer und Kosten hängen von Ihren Prozessen und Rahmenbedingungen ab; sie werden in der Anforderungsphase definiert und vor Beginn in einem Angebot formalisiert.